边课堂 · 边知道
从零造一个大模型
斯坦福 CS336 Language Modeling from Scratch 今年春季第三次开课,由 Percy Liang 和 Tatsu Hashimoto 主讲。19 讲、5 个作业,从 tokenizer、Transformer、GPU kernel 一路做到 scaling law、数据清洗和 RL,代码量至少比其他课多一个数量级。
从一行 Python 开始,自己写 tokenizer、Transformer、优化器,再写 GPU kernel、清洗 Common Crawl、拟合 scaling law,最后用 RL 教模型做数学题,一个学期能走多远?
总览
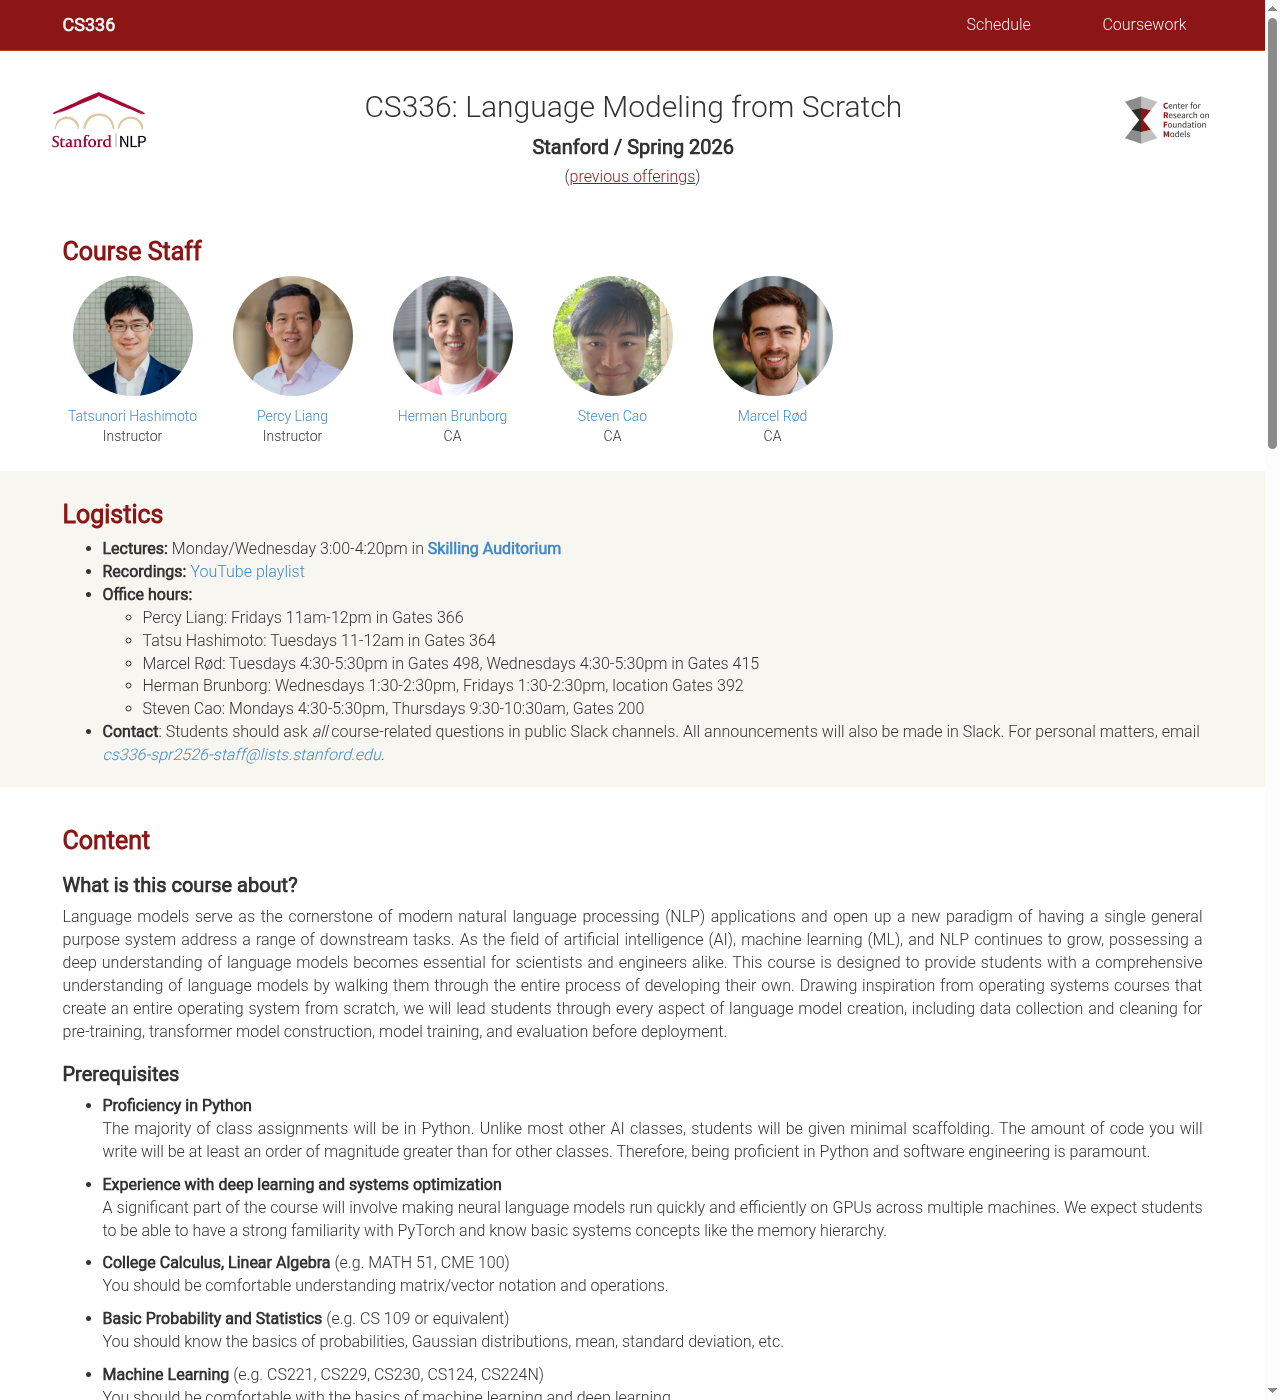
斯坦福 CS336 Language Modeling from Scratch 今年春季(Spring 2026)完成了第三次开课,由 Percy Liang 和 Tatsunori(Tatsu)Hashimoto 主讲。课程主页把思路说得很直白:参照操作系统课「从零写一个操作系统」的做法,带学生走完语言模型开发的每一步,包括预训练数据的收集与清洗、Transformer 构建、模型训练和部署前的评测。
课程结构
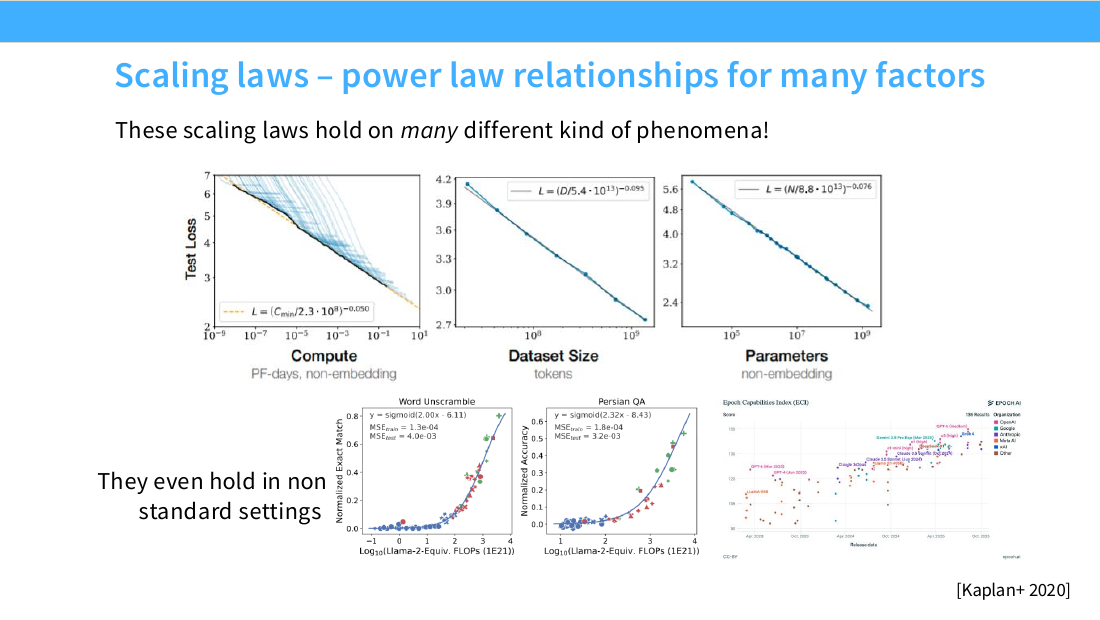
全学期 19 讲,每周一、三上课。大致顺序是:tokenization 和资源核算(FLOPs、显存、arithmetic intensity);架构与超参数、attention 替代方案和 MoE;GPU/TPU、kernel 与 Triton、并行;scaling laws 和推理;评测;数据(来源、过滤、去重、配比、合成数据);最后是 SFT/RLHF、RLVR 和多模态对齐,外加两节嘉宾课。Percy 那一半的讲义是可执行的 Python 文件(lecture_01.py 等),Tatsu 那一半是 PDF 幻灯片。
五个作业
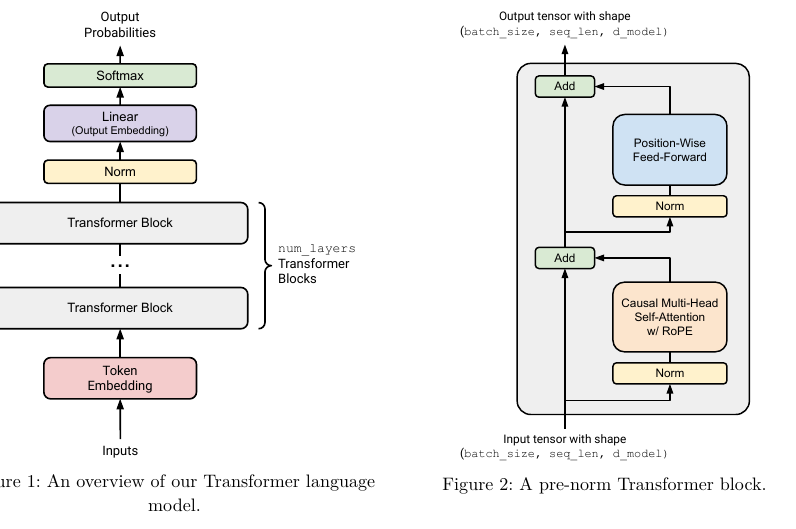
- A1 Basics:从零实现 BPE tokenizer、Transformer LM、cross-entropy 和 AdamW、训练循环,在 TinyStories 和 OpenWebText 上训练。torch.nn 里除了 Parameter 和容器类,基本不许用。
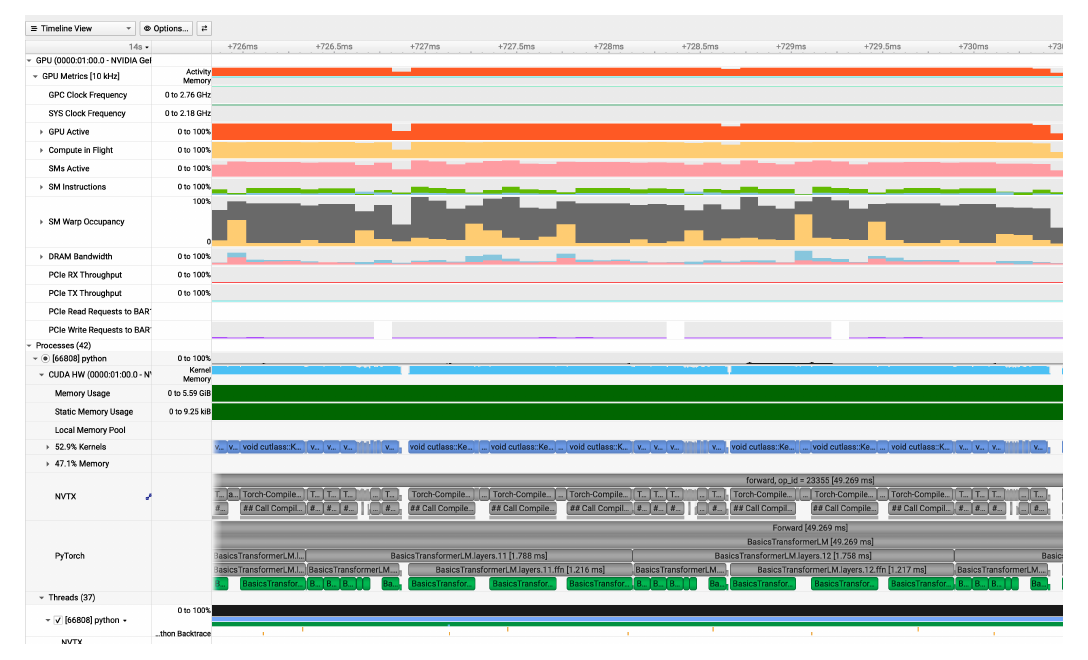
- A2 Systems:做 benchmark 和 profiling,用 Triton 自己写 FlashAttention-2,再实现 DDP、optimizer state sharding 和 FSDP。
- A3 Scaling:不自己训模型,而是调用课程的训练 API,用 12 个 B200 小时的预算拟合 scaling law,预测 48 个 B200 小时下的最优模型和最终 loss,成绩部分取决于预测得准不准。
- A4 Data:把 Common Crawl 原始 HTML 转成文本,做有害内容、PII 等过滤和去重,再用过滤后的数据训模型比较效果。
- A5 Alignment and Reasoning RL:在 OLMo-2-0425-1B 上测 GSM8K 的 prompting 表现,实现 GRPO 及 RFT、Dr. GRPO、MaxRL 等变体;可选的第二部分做 DPO 等安全对齐方法。
算力与排行榜
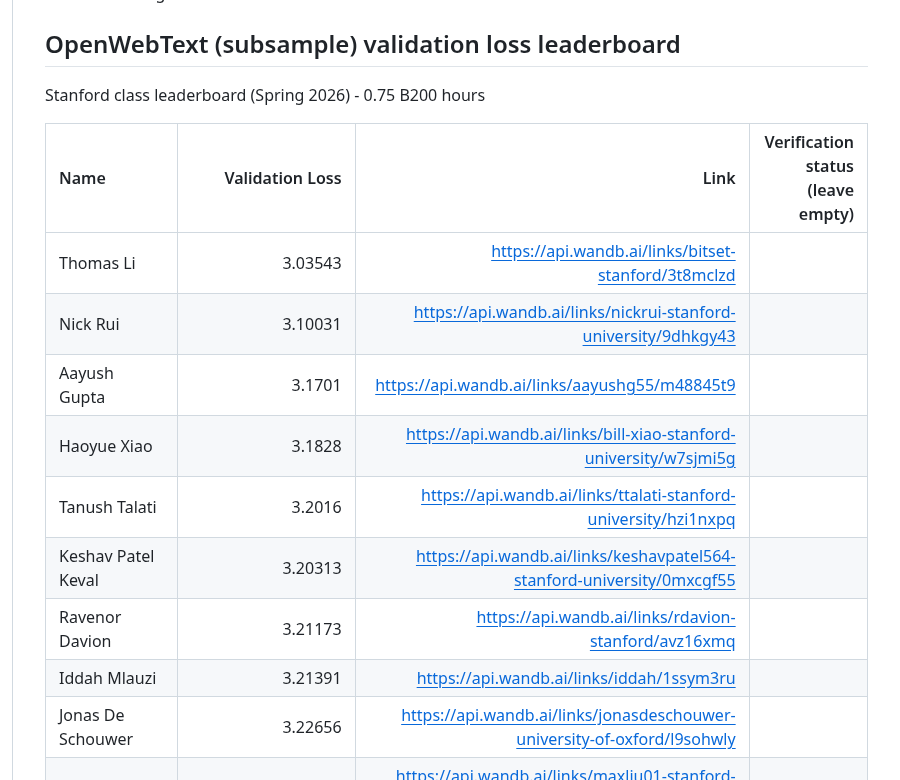
作业的基准硬件是 B200。A1 的排行榜比的是在单张 B200 上 45 分钟内把 OpenWebText 验证 loss 压到多低;A2 的排行榜比在两张 B200 上跑完一个 8B 模型完整训练步的速度,基线是 10 秒。排行榜是 GitHub 仓库,通过 PR 提交,校外学习者也可以提交到单独的表格。
自学者需要自己租卡。主页列了几家云厂商 2026 年 3 月 28 日的单卡 B200 公开价格,从 RunPod 的 $4.99/小时到 Together 的 $7.49/小时不等,赞助方 Modal 每月送 $30 免费额度。课程建议先在 CPU 上调通正确性,再上 GPU。
适合谁
这是 5 学分的课,主页明确说代码量比其他课程至少多一个数量级,脚手架很少。先修要求包括熟练的 Python 和软件工程能力、熟悉 PyTorch 和内存层次结构等系统概念,以及微积分、线性代数、概率统计和机器学习基础。
AI 工具政策也很严格:可以问概念问题和 API 用法,但不允许用 coding agent 或 AI 自动补全来实现作业的任何部分。网上现成的实现也不许参考,讲义本身是自包含的。
怎么跟
全部课程录像在 YouTube 播放列表里,讲义、5 个作业的代码和 handout 都在 GitHub 的 stanford-cs336 组织下公开,Spring 2024 和 2025 两届的页面也还在。想真正理解大模型是怎么一层层造出来的,这门课是目前最完整的公开路线之一:https://cs336.stanford.edu/