边知识 · 边知道
机器人也有了“微调 API”:读懂 Physical Intelligence 的 Pi API beta
Physical Intelligence 发布 Pi API beta:上传机器人数据,在 Pi 的算力上微调基础模型,再用云端 inference 驱动机器人。本文讲清 VLA、微调与云端推理,以及案例、同类对比和尚不清楚的风险。
总览
2026 年 10 月 13 日(美西时间),总部在旧金山的机器人 AI 公司 Physical Intelligence(下文简称 Pi,官方 X 账号 @physical_int)发布了 Pi API 的 beta 版。机器人团队可以把自己采集的机器人数据传上去,在 Pi 的算力上对 Pi 最新的机器人基础模型做 fine-tune,再通过云端托管的 inference 服务直接驱动自己的机器人。
用过大语言模型的人对这套流程不会陌生:OpenAI 等公司早就提供“上传数据、微调模型、调用 API”的服务。区别在于,这次 API 的输出不是一段文字,而是机械臂的动作。
本文从基础概念讲起:什么是机器人基础模型和 VLA,传统机器人为什么要一个任务写一套程序,fine-tune 和云端 inference 放到机器人身上意味着什么。之后介绍官方公布的案例、同类产品对比,以及目前还不清楚的地方。
核心观点
- Pi API 把“改造一个通用机器人模型去完成具体任务”做成了托管服务,用户不需要自己搭训练基础设施和数据管线。
- 早期用户的迭代周期已经能缩短到几天,例如 Almond 用 4 天就让自家机器人学会了一道去毛刺工序。
- 这是 Pi 第一个明确的商业化产品,也是它收集真实世界任务数据、形成数据飞轮的入口。
- 目前价格、许可条款、底层模型版本、推理延迟都没有公开,官方也承认部分云端部署遇到过网络问题。
基础概念一:传统机器人为什么要“一个任务一套程序”
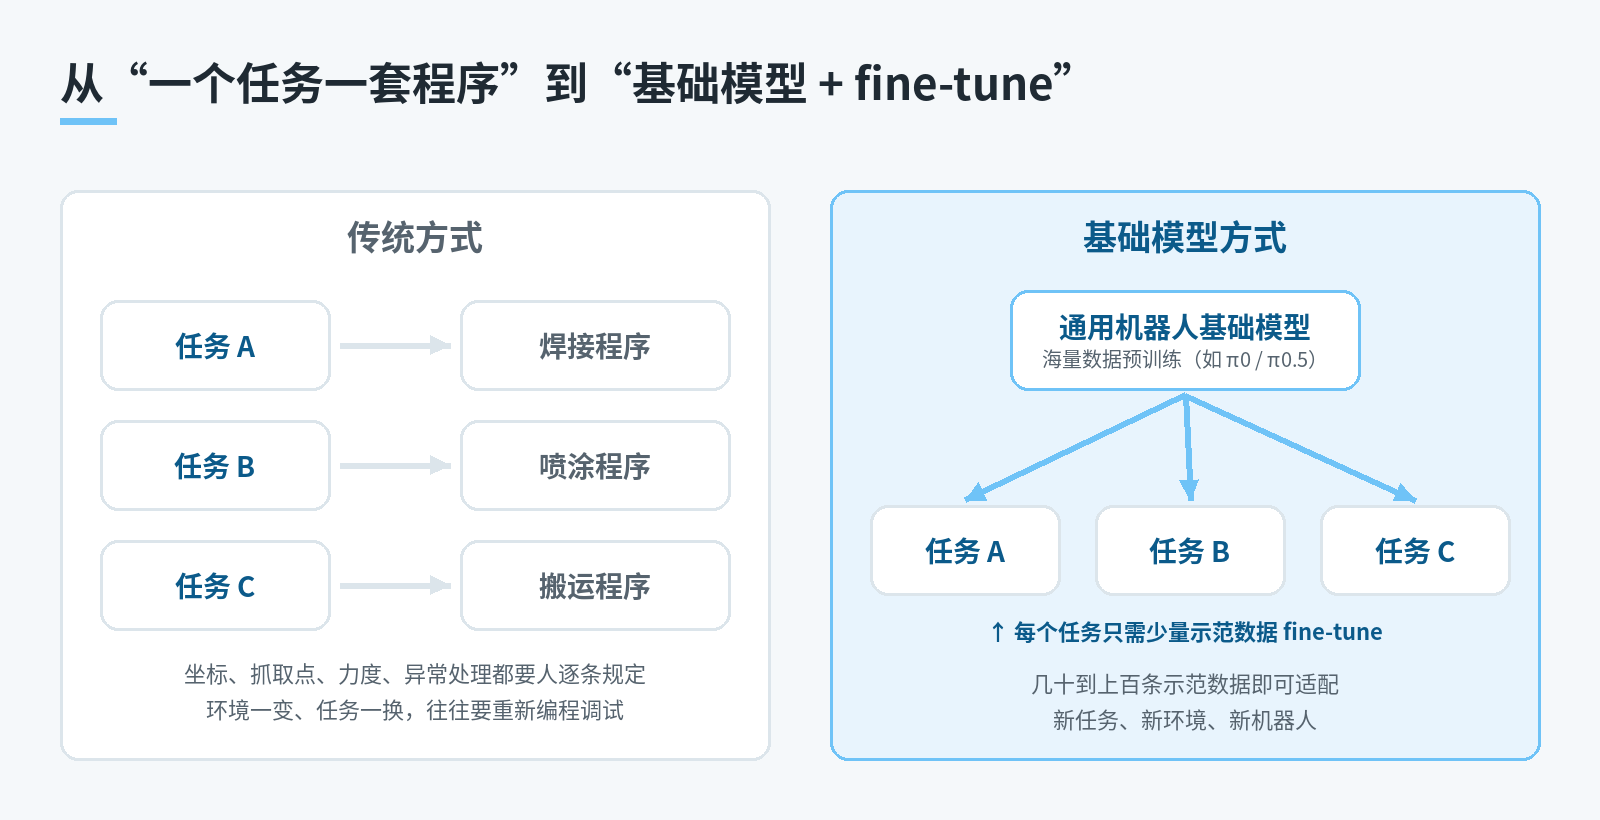
工厂里的工业机械臂很早就能精确地焊接、喷涂、搬运,但它们的“聪明”主要来自工程师预先写好的程序:零件放在哪个坐标,抓取点在哪里,力度多大,出现异常时怎么处理,都要人一条条规定。
这种做法在高度标准化的产线上很有效,一旦环境变了就会出问题:零件摆歪几厘米、换了一种包装、光照变暗,原来的程序就可能失效。换一个任务,往往要重新编程、重新调试,成本可能比机器人本身还高。所以过去几十年,机器人主要待在结构化的工厂里,很难进入厨房、农田、仓库这些多变的环境。
基础概念二:机器人基础模型与 VLA
大语言模型的经验是:先在海量数据上训练一个通用的“基础模型”,它学到了广泛的知识,再针对具体用途做少量调整,就能处理各种任务。
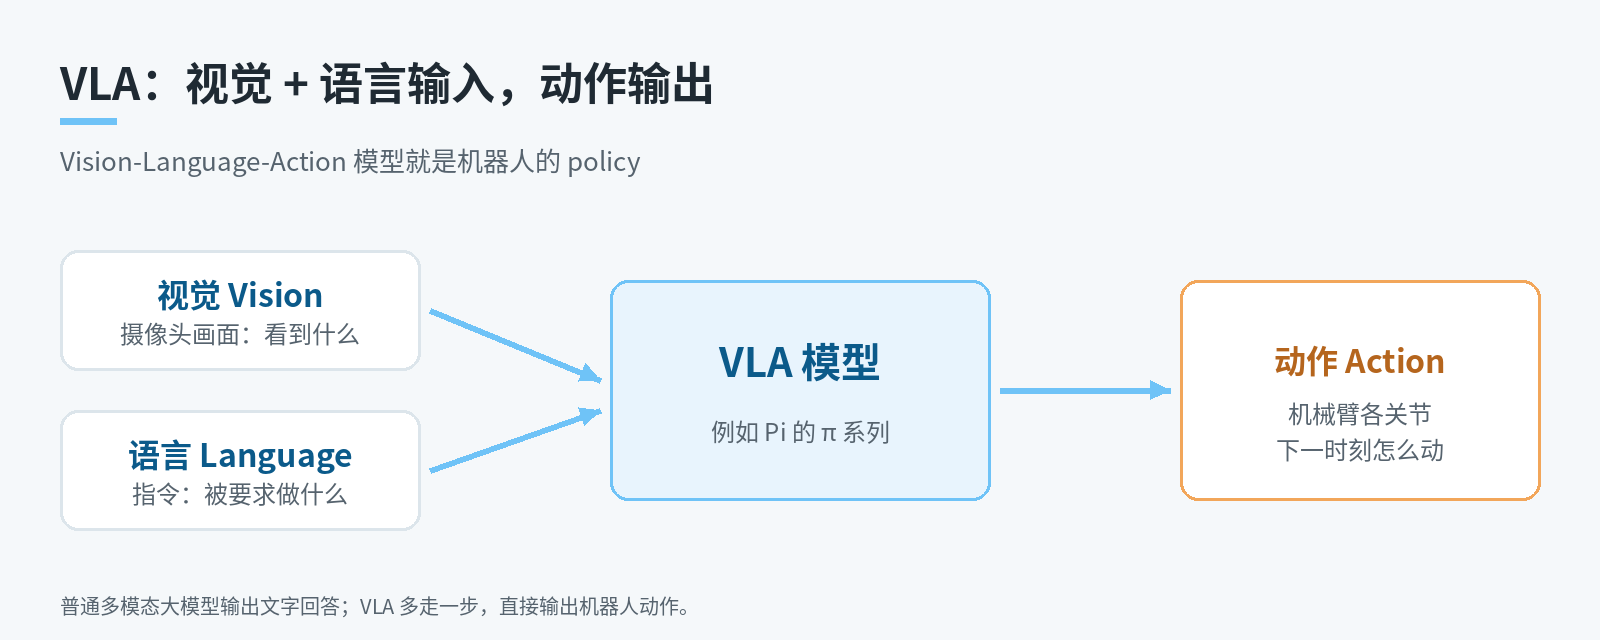
机器人领域也在走这条路。VLA 是 Vision-Language-Action(视觉-语言-动作)模型的缩写。普通的多模态大模型能“看懂图像、听懂指令、说出回答”,VLA 在此基础上多了一步:直接输出机器人的动作,比如机械臂各关节下一时刻该怎么动。这样一个模型就成了机器人的 policy,也就是从“看到什么、被要求做什么”到“做什么动作”的映射。
Pi 的 π 系列就是这类模型。官方博客说,π0、π0.5 这类通用机器人基础模型“提供了扎实的物理知识和能力基础,大幅减少了适配新任务、新环境、新机器人所需的数据和精力”。Pi 之前也通过 GitHub 上的 openpi 项目开源过 π0 / π0.5 的权重和 fine-tune 代码,附带 ALOHA、DROID 等机器人平台的示例。
基础概念三:fine-tune 和云端 inference 对机器人意味着什么
基础模型很强,但不会天生就会某家工厂的某道工序。这时需要 fine-tune:用目标任务的几十到上百条示范数据(通常由人遥操作机器人完成,即 tele-op),在基础模型上继续训练,让它适应具体的机器人和任务。
问题是,fine-tune 本身门槛很高。官方博客的说法是,适配这些模型“仍然需要 ML 基础设施、算力和复杂的数据管线,这些本身就很难”。一家做厨房机器人或农业机器人的公司,核心能力是硬件和场景,未必有一支能维护大规模训练集群的团队。
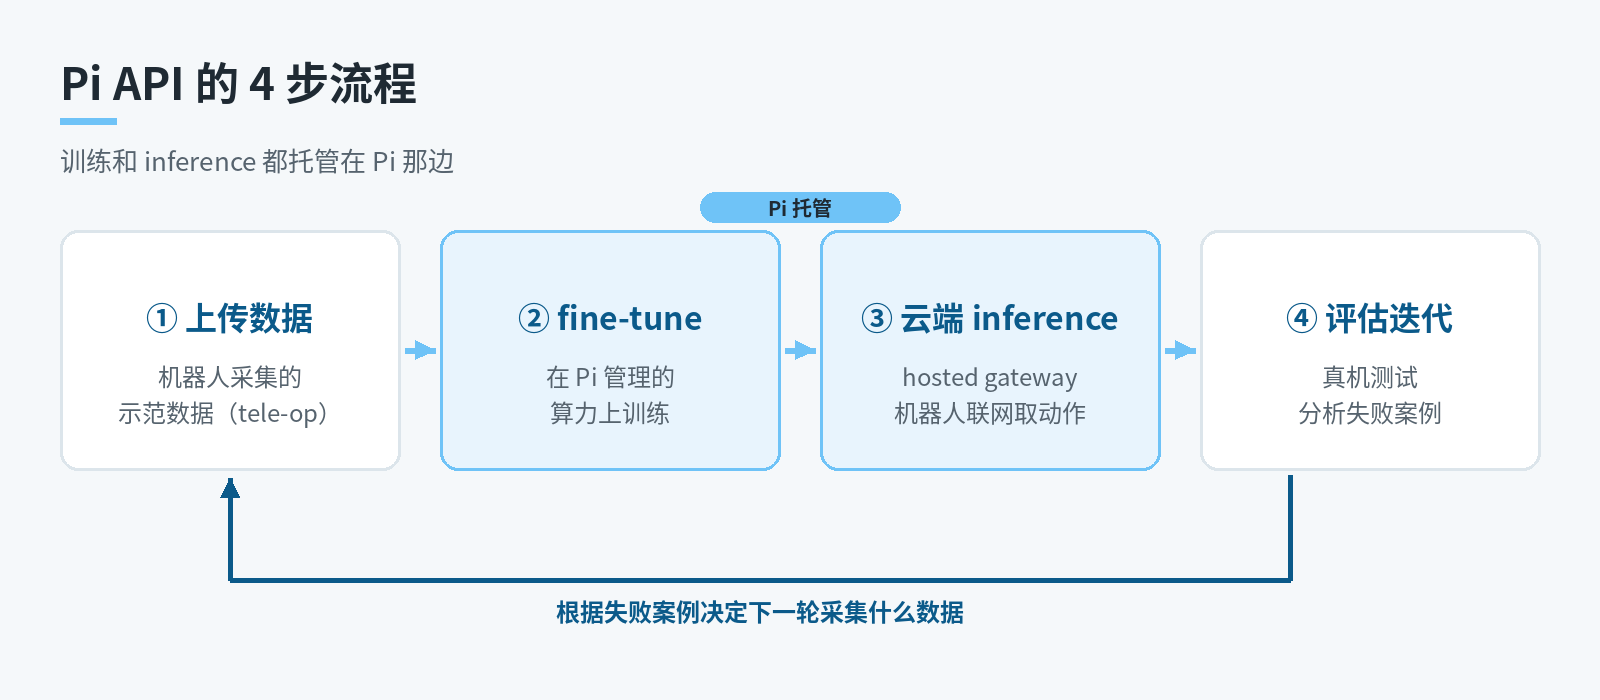
Pi API 的做法是把这部分全部托管:
- 上传数据:把自己机器人采集的示范数据传给 Pi。
- fine-tune:在 Pi 管理的算力和基础设施上训练。
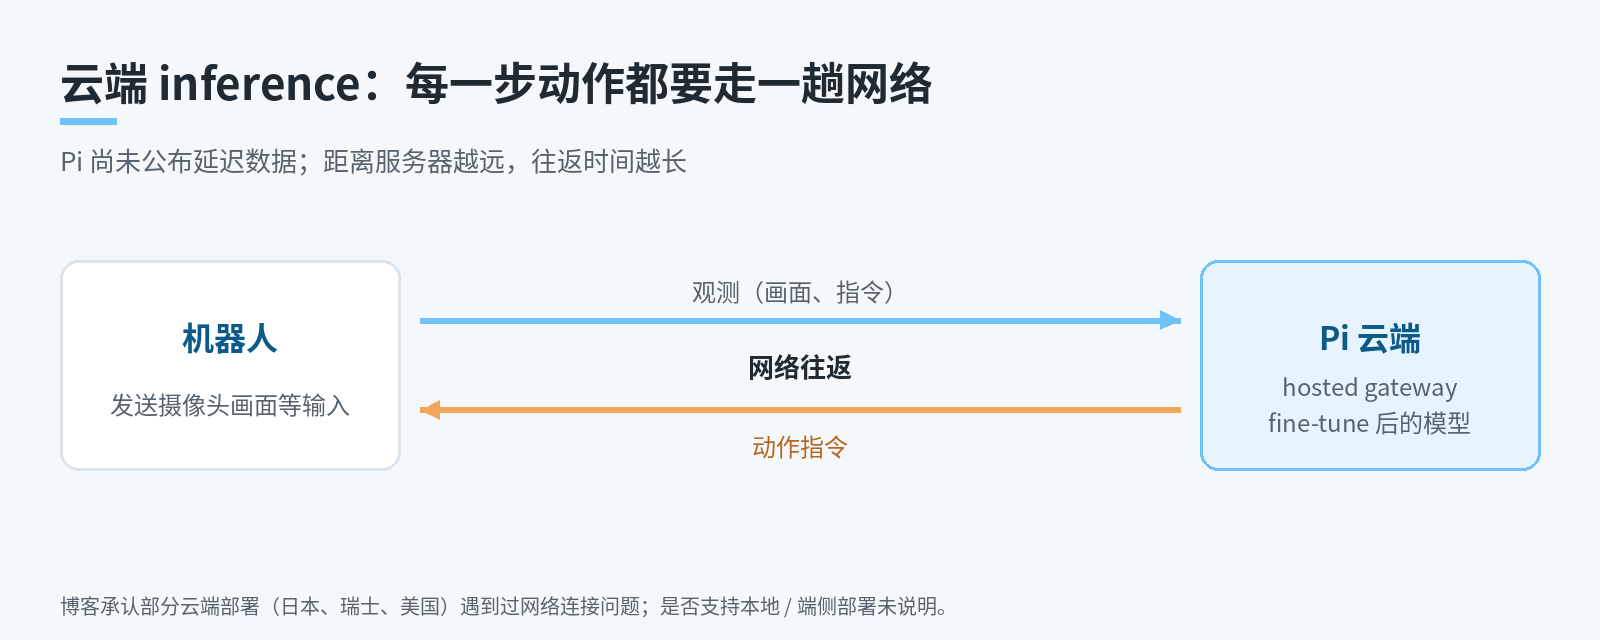
- inference:fine-tune 好的模型部署在 Pi 的 hosted gateway 后面,机器人在运行时通过网络把摄像头画面等输入发过去,拿回动作指令。
- 评估迭代:在真实机器人上测试,根据失败案例决定下一轮采集什么数据。
inference 指模型“推理”出结果的过程。对聊天机器人来说,晚几百毫秒回答无伤大雅;对正在抓东西的机械臂来说,响应速度直接影响动作是否稳定。这一点后文会单独讨论。
数据飞轮:为什么 Pi 要开放 API
Pi 在博客里讲得很明白:模型被用得越多,Pi 越了解它在真实世界中的潜力和局限,就越能让下一代模型适用得更广。现实中的机器人任务种类极多,机器人建筑、机器人手术、仓储自动化,每一个都需要一整家公司来做。如果每个应用都要从零解决“物理智能”问题,难度会高到无法承受。
于是形成一个循环:Pi 提供通用模型,各行业公司在上面解决自己的问题,这些部署又帮 Pi 理解更多任务,反过来改进基础模型。这就是常说的数据飞轮。
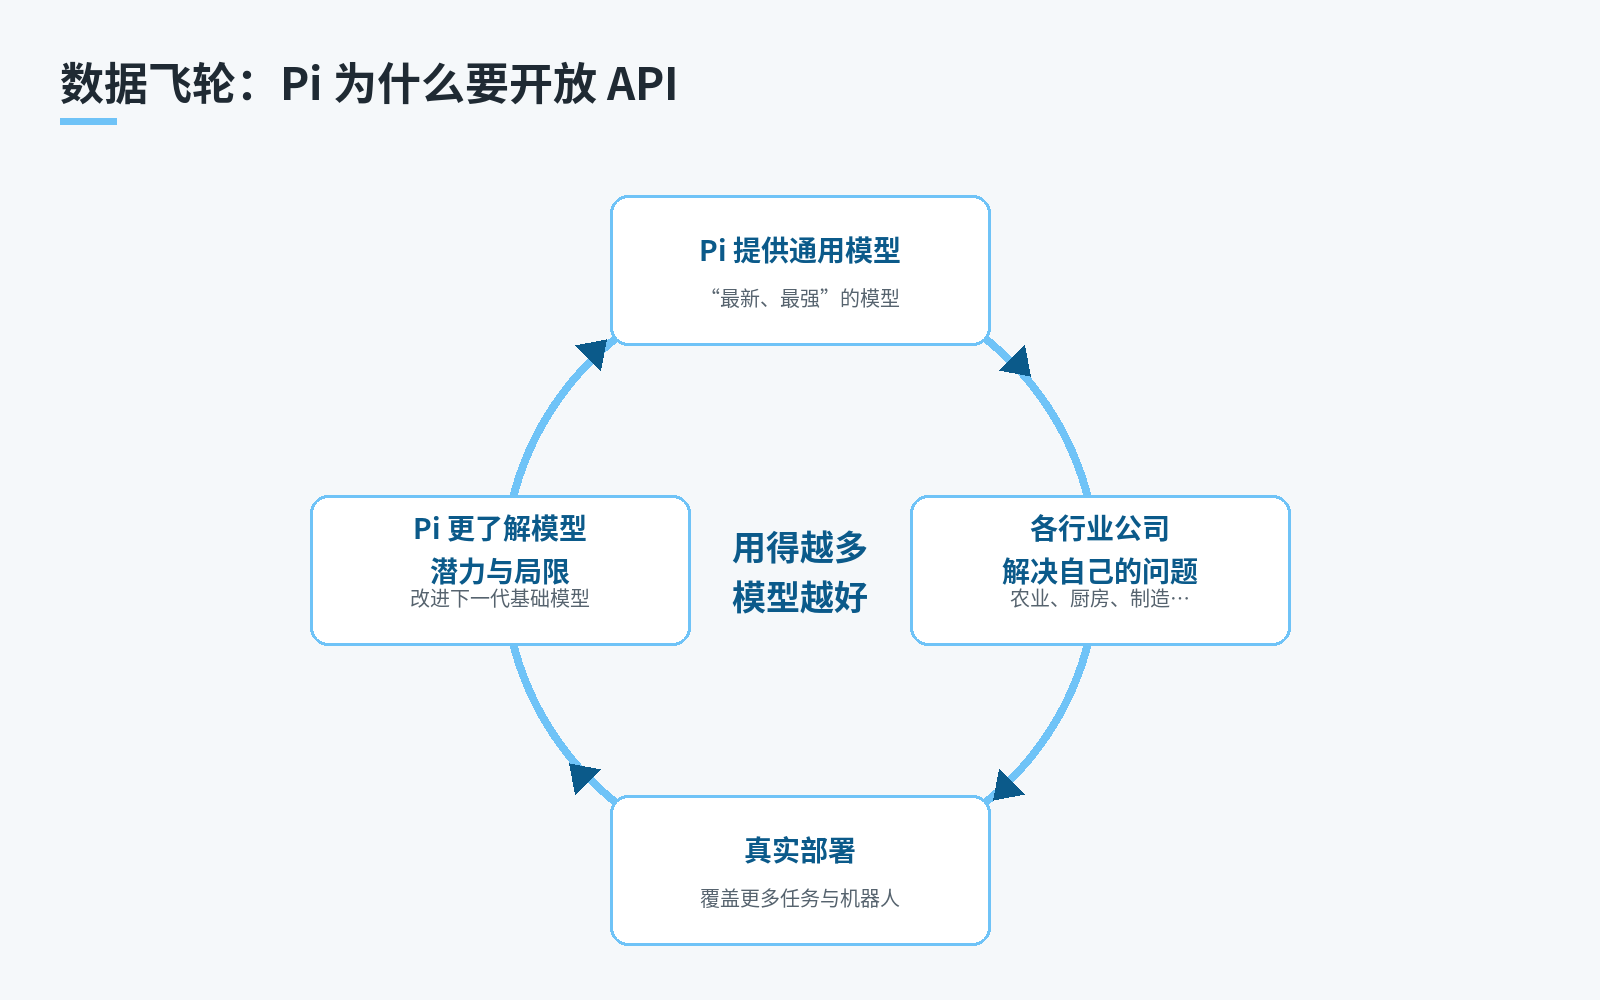
博客还提到,Pi 能快速更新 API 背后的模型,计划持续开放“最新、最强”的模型。对用户来说,底层模型升级可能直接带来效果提升,不需要自己重新训练基础模型。
案例:从去毛刺到无人装载机
官方博客展示了一批合作方和早期用户。其中两个案例很有代表性。
Almond 的 Axol:4 天学会去毛刺。 Almond 是旧金山的一家公司,做双臂机器人 Axol,目标是让 Axol 能“自己造自己”。视频里,Axol 在给自己组装时要用的垫片(spacer)去毛刺(deburr)。按官方说法,这个模型是 Almond 团队用 Pi API 迭代了 4 天得到的。去毛刺是典型的精细制造工序,过去通常需要专门编程或人工完成。
Actor 的无人装载机。 Actor 做自动驾驶重型机械。在犹他州的一次真实商业部署中,它的自动轮式装载机铲起物料、装进自卸卡车,驾驶室里没有操作员。这说明 Pi 的模型不只用在桌面机械臂上,也被用在大型工程机械上。
其他出现在博客里的公司还有 AgRobotics、CloudChef、Ultra、Weave、Argon Robotics、Chef Robotics、Deft、Dream Machines、Formic、Foundry、Frontier Machines、General Instinct、Intuition.dev、Omakase、robot.com、Yondu 等,场景从农业采摘、厨房、乳业到服务器组装都有。Pi 在 X 上的发布帖也把跨度概括为“从收获草莓到组装服务器”。
联合创始人 Sergey Levine 在 X 上写道:“即使在一年前,我也不会相信 PI 的模型能在这么多种不同的机器人上运行。”需要注意,Pi 没有公布正式的支持硬件清单,上面这些是合作案例,不等于任何机器人都能直接接入。
怎么拿到权限
目前 Pi API 只接受申请。waitlist 页面写着“从小规模开始,分批 onboarding”。申请表会问:
- 团队规模,由谁负责训练 policy;
- 团队做过哪些事,比如把模型或外部 API 接入机器人控制栈、采集和整理机器人数据、fine-tune policy 并在实体机器人上运行、通过反复实测比较不同 policy(表单举了 ACT、diffusion policy、π0.5 的例子);
- 想用 API 完成什么具体任务;
- 已采集多少小时的 tele-op 数据;
- 机器人配置。
从这些问题看,Pi 当前更想找已经有机器人、有数据、有一定 ML 经验的团队,而不是零基础的爱好者。Pi 团队的 Chelsea Finn 在 X 上表示,已经有很多人在用它 fine-tune π 模型,接下来希望“大幅扩大测试规模”。
同类产品对比
Pi 并不是唯一在做“机器人模型平台”的公司。
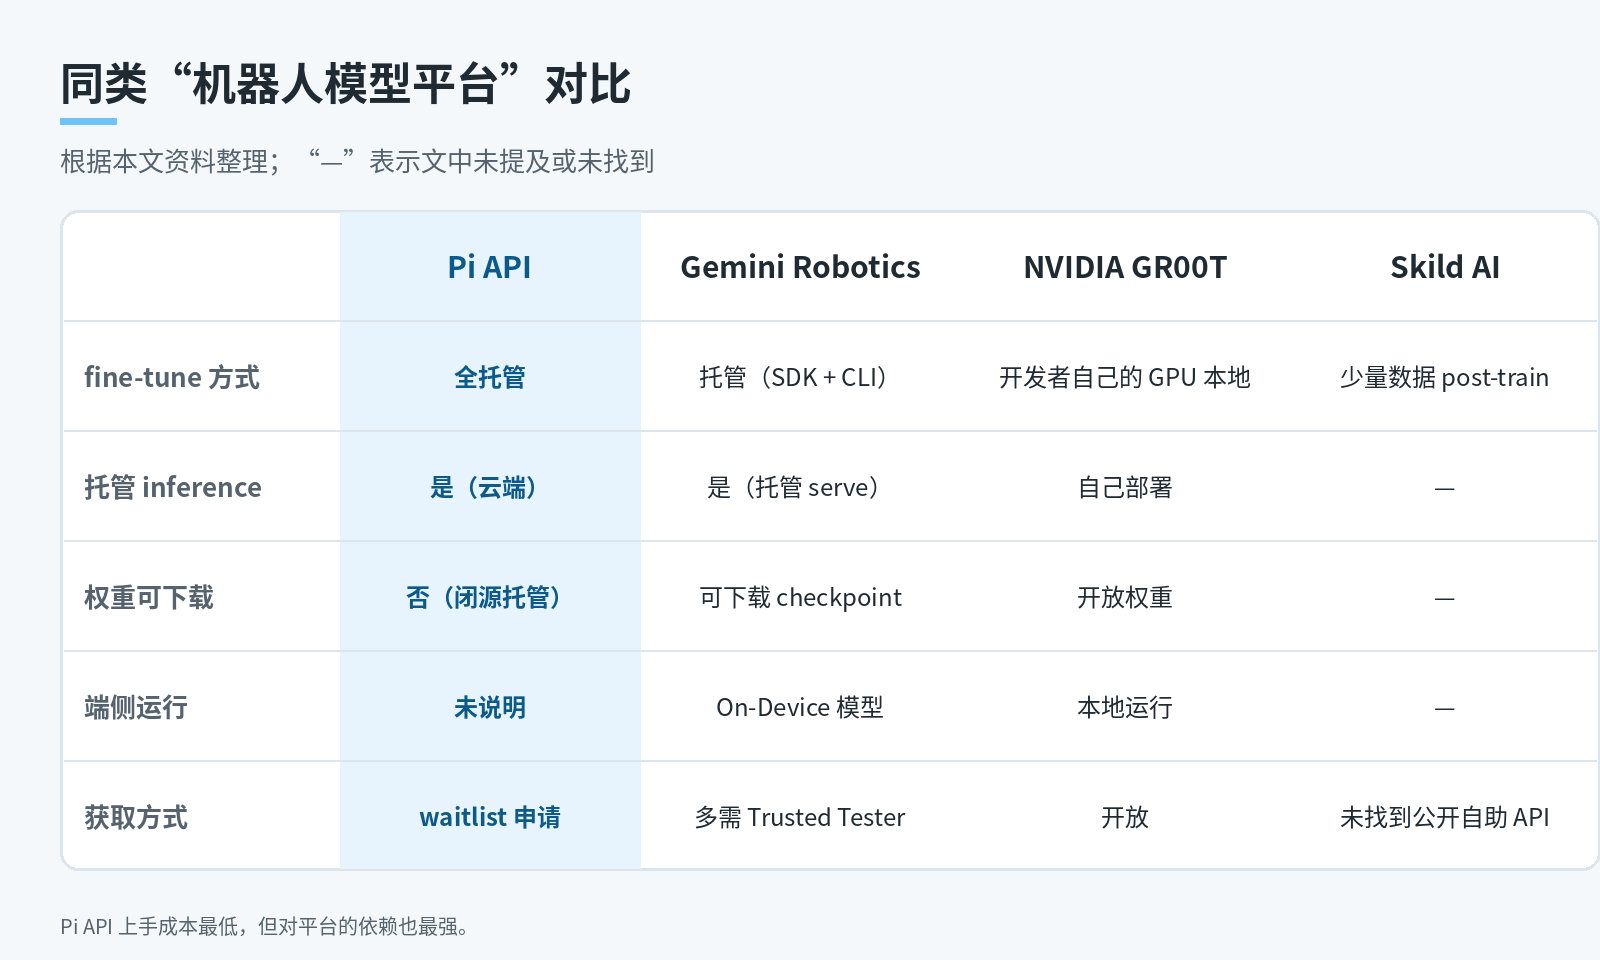
Google DeepMind Gemini Robotics。 通过 Safari SDK 和 flywheel 命令行工具,可以上传数据、发起 fine-tune、托管 serve 模型、下载 fine-tune 后的 checkpoint,还提供可在本地运行的 On-Device 模型。大部分功能需要加入 Trusted Tester 计划。这是和 Pi API 最接近的产品,主要区别是可以下载 checkpoint、在端侧运行。
NVIDIA Isaac GR00T。 走开放权重路线。以 GR00T N1.6 为例,开发者在自己的 GPU 上用 LeRobot 格式的数据本地 fine-tune,新机器人用 NEW_EMBODIMENT 标签配置。好处是完全自主可控,代价是基础设施和训练要自己负责。
Skild AI。 主打 Skild Brain,强调一个“omni-bodied”的模型适配四足、人形、桌面机械臂、移动操作平台等各种形态,用少量任务数据做 post-train,并与 ABB、Universal Robots、NVIDIA 合作。目前没有找到它提供公开的自助 fine-tune API。
总体看,Pi API 的定位是“全托管”:训练和 inference 都在 Pi 那边,上手成本最低,但对平台的依赖也最强。
风险与未知
延迟与网络。 博客承认,展示的大多数应用(分布在日本、瑞士和美国)用的是云端托管 inference,部分部署遇到了网络连接问题。研究者 Lucas Beyer 在 X 上提问:离 Pi 的服务器较远时,fine-tune 后的 inference 延迟会不会成问题?Pi 目前没有公布延迟数据。官方也没有说明是否支持本地或端侧部署;第三方报道提到申请表里有 cloud / local / hybrid 的偏好选项,但这不能证明本地部署已经可用(未确认)。
价格不透明。 官方没有公布任何价格、计费单位、最低消费或免费额度。第三方价格追踪站特意提醒:“未公开不等于免费”。
许可条款不明。 API 是闭源托管服务,和开源的 openpi 不是一回事。fine-tune 后模型的归属、数据使用条款等,目前都没有公开文件(未确认)。
模型版本不明。 博客只说 API 提供的是“最新模型”,没有给出版本名。日本 D1 Humanoid 的一位成员在 X 上称,他们基于“尚未公开的最新模型 π0.7”为 D1 做了 post-training,Sergey Levine 转发了这条帖子。但 API 底层是否就是 π0.7,Pi 官方没有确认(未确认)。
公司背景
Physical Intelligence 在 2026 年 3 月的报道中被称为“成立两年”的公司,创始团队包括学术界的 AI 研究者和前 Google DeepMind 研究员,TechCrunch 报道中提到的联合创始人有 Sergey Levine 和 Lachy Groom。据 TechCrunch 2026 年 3 月的报道(援引 Bloomberg),Pi 当时正在洽谈约 10 亿美元的新融资,估值超过 110 亿美元,Founders Fund、Lightspeed 等参与,Thrive Capital、Lux Capital 继续跟投;上一轮估值为 56 亿美元。同一报道提到,到 2026 年 1 月,Pi 累计融资略超 10 亿美元,约有 80 名员工。这一轮融资是否已完成,目前没有公开确认(未确认)。
Levine 当时对 TechCrunch 说,可以把 Pi 理解为“机器人的 ChatGPT”;Lachy Groom 则表示公司没有商业化时间表。放在这个背景下看,Pi API 是这家一直以研究为主的公司第一次明确地把模型变成产品。几天前,Pi 的合作方 Ultra 宣布完成 5000 万美元 A 轮融资,Pi 在 X 上转发祝贺,称其是“通用机器人基础模型与真实部署结合”的例子。
结语
Pi API beta 的意义不在于某个单项技术突破,而在于交付方式:让一家机器人公司不必成为 AI 基础设施公司,也能在几天内把前沿模型用到自己的机器人上。它能走多远,取决于几个目前还没有答案的问题:云端 inference 能否满足实时控制的要求,价格是否负担得起,许可条款是否让企业放心把核心数据和模型交给 Pi。