边知识 · 边知道
同价同周的两款 Flash:MiniMax M3.1 Flash 对 DeepSeek V4.1-Flash-1017
MiniMax M3.1 Flash 与 DeepSeek V4.1-Flash-1017 同周发布、闲时同价。本文整理官方参数、第三方榜单和 20 多条用户实测:DeepSeek 榜单与编程领先、吞吐更高,MiniMax 审美类作品受好评但幻觉率 93%,并标注单次实测、免费期和高峰价等局限。
总览
2026 年 10 月 17 日,DeepSeek 发布 V4.1 Flash 的小版本更新 V4.1-Flash-1017;两天后的 10 月 19 日,MiniMax 正式发布 M3.1 Flash。两款模型都是 MoE 架构、1M 上下文,官方标价也几乎一样,发布后很快就有大量用户把它们放在一起比。
本文把官方参数、第三方榜单和社区实测整理到一起(数据截至 2026-10-20 08:15,北京时间),结论先列在这里:
- 价格基本相同:两者闲时都是每百万 token 输入 $0.15、输出 $0.60。区别在于 DeepSeek 在高峰时段价格翻倍,MiniMax 全时段统一。“MiniMax 便宜一半”只在 DeepSeek 高峰时段成立。
- 第三方榜单整体是 DeepSeek 领先:Artificial Analysis 智能指数 45 对 42,输出速度约 210.6 对 120.1 tok/s;Arena WebDev 1664 对 1587。
- MiniMax 知识题答对更多,但幻觉率高达 93%:AA-Omniscience 正确率 56% 对 43%,可不会的题几乎都给出错误答案,很少承认不知道。
- 官方基准各有胜负:DeepSeek 赢下编程类基准,MiniMax 赢下办公自动化基准 Automation-Bench。
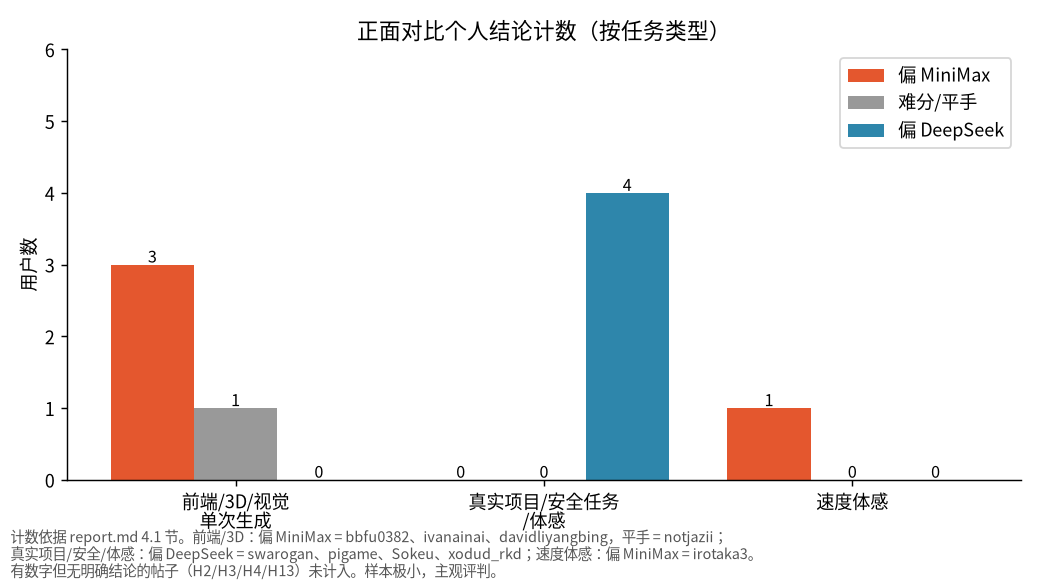
- 用户实测结果分裂:前端、3D、视觉类“同提示词”作品里,多位用户更喜欢 MiniMax 的成品;真实项目和安全类任务的反馈偏向 DeepSeek。
- MiniMax 默认思考档位为 max 且无法关闭思考,单任务往往更慢、token 更多;调到 low 档后又成了最便宜的配置。
需要提前说明:下文的个人实测几乎都是单次运行(n=1),提示词、harness、渠道、effort 档位和时段都不统一,只能看趋势,不能直接横向比较。MiniMax 正式版发布还不到 24 小时,不少“实测”其实来自更早的 Space Bunny 匿名版或 Preview 版。
两款模型的基本参数
两款模型的定位相近,都是各家主力模型的“Flash”版本,主打便宜和快。官方公布的参数如下 [官方]:
| 项目 | MiniMax M3.1 Flash | DeepSeek V4.1-Flash-1017 |
|---|---|---|
| 发布 | 2026-10-19(Space Bunny 匿名版 09-23 已上线 OpenRouter / OpenCode) | 2026-10-17(V4.1 Flash 小版本更新;V4.1 Flash 首发于 09-10) |
| 架构 / 参数 | MoE,总 428B / 激活约 23B(MarkTechPost 引产品页) | MoE 552B,输入激活 8B / 输出激活 16B(09-10 官方博客) |
| 上下文 / 最大输出 | 1M / 约 512K(524,288 硬上限,Reddit 用户实测) | 1M / 384K |
| 输入模态 | 文本、图片、视频 | 文本、图片 |
| 思考模式 | 始终开启,不可关闭;low / medium / high / xhigh / max 五档,默认 max | 思考 / 非思考均可,默认思考 |
| 开源权重 | 据媒体报道计划 10-23 放出(按 Arena 标注为 MiniMax Community License) | 已开源,MIT |
| 官方速度 | 日常 200+ tok/s,P50 170+ tok/s,比 M3 快约 3 倍 | 未单列 |
DeepSeek 的参数量还有一种 763B 的说法,来自一条 X 帖子,未核实,本文以官方博客的 552B 为准。
MiniMax 官方还称,M3.1 Flash 的 agent 任务综合成本比前代低 70%,但没有详细披露计算方法。
价格:同价,但 DeepSeek 有高峰时段
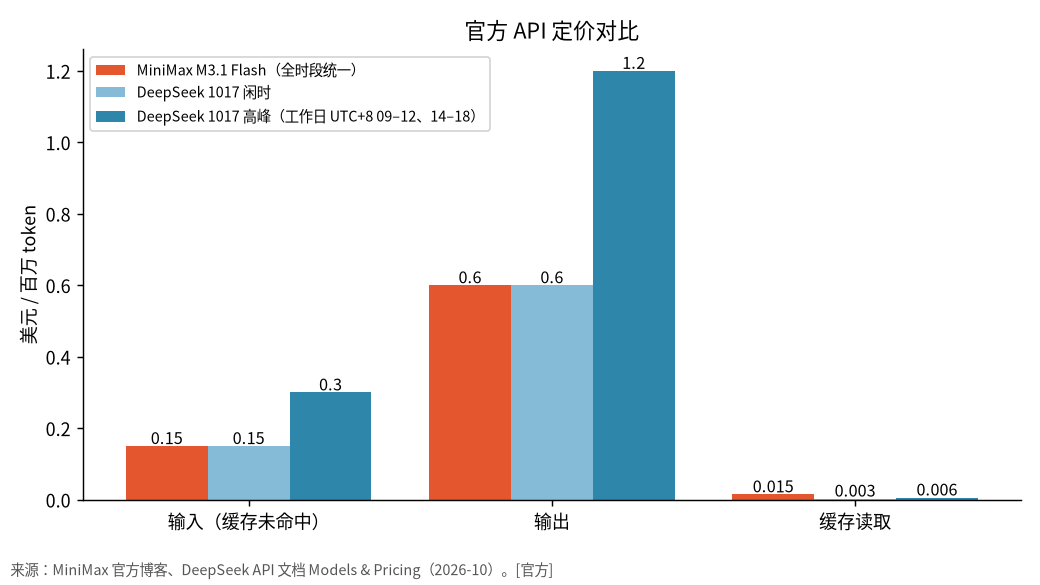
按每百万 token 计:
- MiniMax M3.1 Flash:输入 $0.15、输出 $0.60、缓存读取 $0.015,全时段统一(人民币为 1 元 / 4 元 / 0.1 元)。
- DeepSeek V4.1-Flash-1017 闲时:输入 $0.15、输出 $0.60、缓存命中 $0.003。
- DeepSeek V4.1-Flash-1017 高峰:输入 $0.30、输出 $1.20、缓存命中 $0.006。高峰时段为周一至周五 UTC+8 09:00–12:00 和 14:00–18:00,正好覆盖国内工作时间。
也就是说,国内用户白天上班时间调用 DeepSeek,价格是 MiniMax 的两倍;晚上和周末两者同价。DeepSeek 的缓存命中价则明显更低。
MiniMax 官方发布的成本对比图里,DeepSeek 是按高峰价计算的,这一点由 X 用户 @mharshald 指出。图中每个任务约 4.6 美分对约 9 美分,如果改按 DeepSeek 闲时价计算,差距会大幅缩小。
官方基准:编程归 DeepSeek,办公自动化归 MiniMax
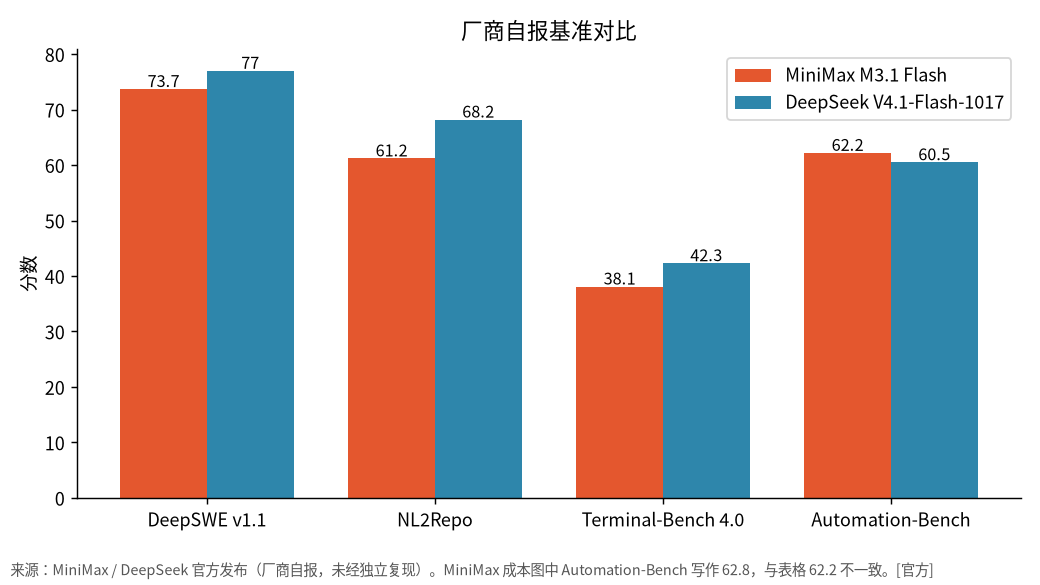
两家各自发布了基准成绩,MiniMax 的表格里还引用了 DeepSeek 的数据 [官方]:
| 基准 | M3.1 Flash | V4.1-Flash-1017 | 结果 |
|---|---|---|---|
| DeepSWE v1.1 | 73.7 | 77.0(旧版 74.2) | DeepSeek 领先 |
| NL2Repo | 61.2 | 68.2 | DeepSeek 领先 |
| Terminal-Bench 4.0 | 38.1 | 42.3(旧版 31.2) | DeepSeek 领先 |
| CyberGym | 82.2 | 88.1 | DeepSeek 领先 |
| Agents' Last Exam | 29.6 | 35.4 | DeepSeek 领先 |
| Automation-Bench v1.0.6 | 62.2 | 60.5(旧版 54.8) | MiniMax 领先 |
| BabyVision(w/ tools) | 91.0 | 92.5(旧版 89.6) | 接近 |
| HLE(MiniMax 为无工具) | 43.4 | 42.6(旧版 36.8) | 接近 |
DeepSWE、NL2Repo、Terminal-Bench 这类编程和仓库级任务,DeepSeek 都领先;MiniMax 唯一明确领先的是办公自动化基准 Automation-Bench,而这项成绩本身有矛盾:MiniMax 的表格写 62.2,成本图里写 62.8。
另外,OSWorld V2(61.7)、BankerToolBench(76.2)、LOCA-Bench 256K(60.3)只有 MiniMax 报告了成绩,DeepSeek 没有对应数据,无法比较。
第三方榜单:DeepSeek 整体领先
厂商自报的成绩各说各话,第三方榜单的结论更一致:总体是 DeepSeek 领先 [第三方]。
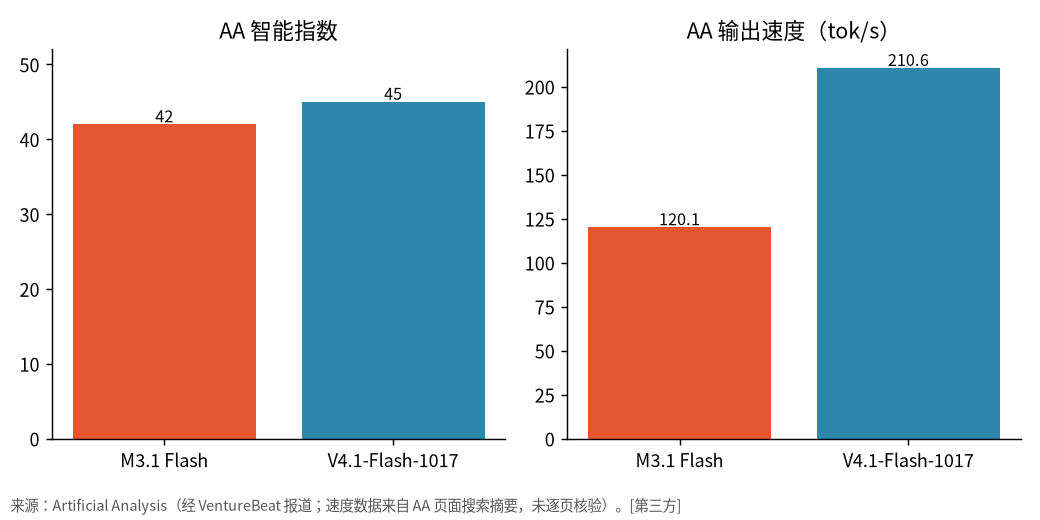
Artificial Analysis(AA):据 VentureBeat 报道及 AA 页面,DeepSeek 1017 的智能指数为 45,与 GLM-5.3 并列开源模型第二档;MiniMax M3.1 Flash 为 42,比前代 M3 的 29 提升明显。输出速度方面,DeepSeek 约 210.6 tok/s,MiniMax 约 120.1 tok/s(这组速度来自 AA 模型页的搜索摘要,未逐页核验)。AA 跑完整套评测的每任务成本,MiniMax 约 $0.22,DeepSeek 约 $0.26。
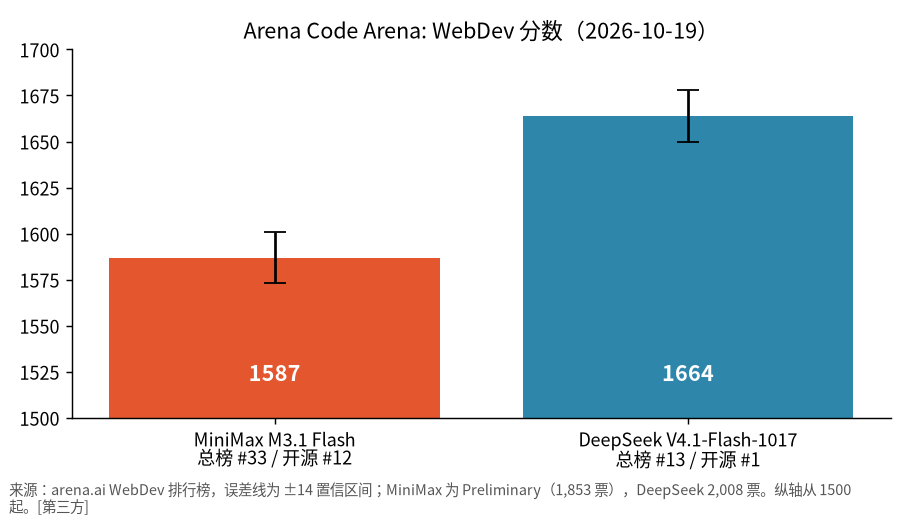
Arena Code Arena: WebDev(10 月 19 日数据):DeepSeek 1664 ±14 分,总榜第 13、开源第 1(2,008 票);MiniMax 1587 ±14 分,总榜第 33、开源第 12(1,853 票,仍为 Preliminary 状态)。DeepSeek 自己宣传的是 1670 分、第 12 名,和当前页面略有出入,榜单在动态更新。
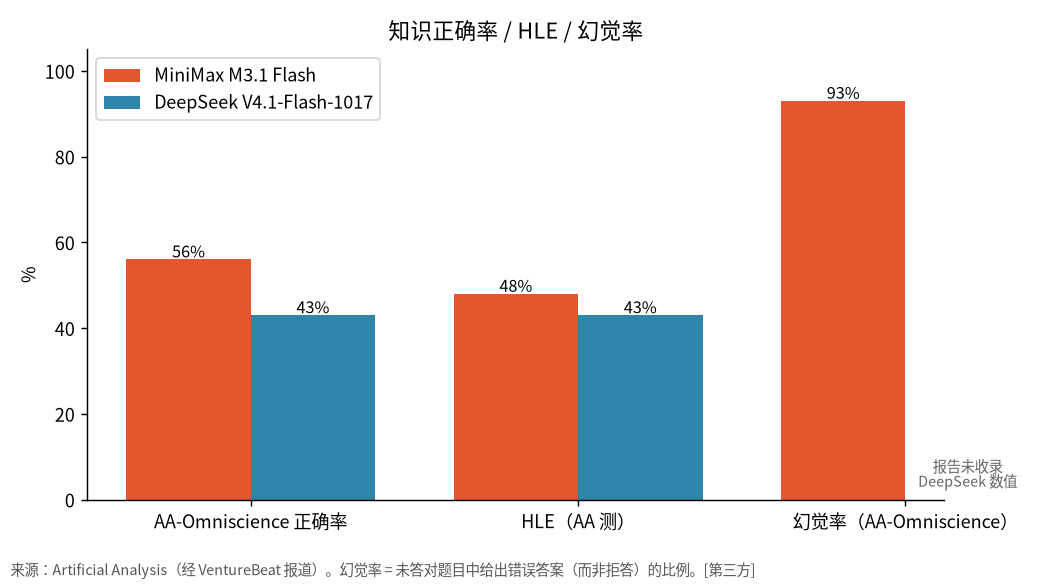
知识与幻觉:这是 MiniMax 表现最两极的一项。在 AA 的 HLE 和 CritPt 上,MiniMax 为 48% / 22%,DeepSeek 为 43% / 24%。AA-Omniscience 知识测试中,MiniMax 正确率 56%,高于 DeepSeek 的 43%;但 MiniMax 的幻觉率是 93%,总分只有 16。幻觉率衡量的是“不会的题里,有多少给出了错误答案而不是拒答”,93% 意味着 MiniMax 碰到不会的问题,几乎总是硬编一个答案。
其他几项参考:
- benchlm.ai 综合分:MiniMax 67.1,DeepSeek 65.67。这个榜单聚合了厂商自报数据,页面自己也写明“Conditional ranges do not establish rank”,参考价值低。
- AIHubMix 对比页:MiniMax 首字延迟(TTFT)1.9 s、95.1 tok/s;DeepSeek TTFT 2.8 s、137.7 tok/s。这是单个渠道的测量。
- OpenCode 用量榜:据 @xiax0603 转述的 OpenCode 数据,Space Bunny 连续 12 天第一,约 106 万亿 token;DeepSeek 第二,约 62 万亿。但 MiniMax 当时免费,用量不代表质量。
用户实测:同一个提示词,结论却分成两派
社区里同时测两款模型的帖子不少,但真正给出量化数字的正面对比只有约 6 条。下面按任务类型整理。
带数字的正面对比
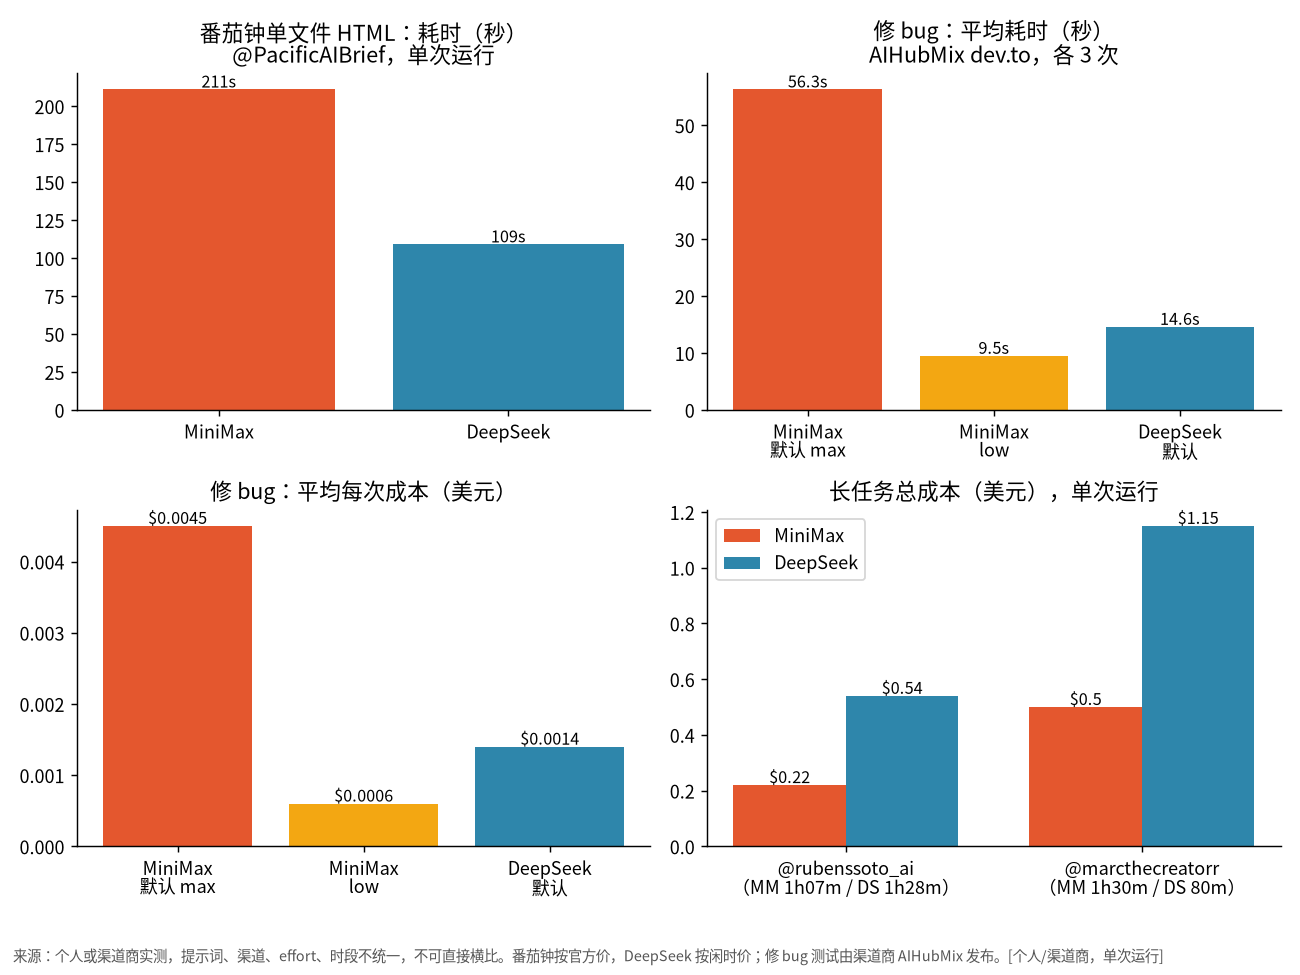
番茄钟单文件 HTML:@PacificAIBrief(中文版账号 @PacificAI_CN)让两者一次生成一个番茄钟网页,两个都能用。DeepSeek 用时 109 s、16.9K 输出 token、约 $0.010(闲时价);MiniMax 用时 211 s、31.6K token、约 $0.019。
修 bug 任务:渠道商 AIHubMix 在 DEV Community 发布了一组测试:一个含 2 个 bug 的 Python 任务,215 个隐藏测试,每个模型跑 3 次,全部通过。默认设置下,DeepSeek 平均 14.6 s、$0.0014;MiniMax(默认 max 档)56.3 s、$0.0045。把 MiniMax 调到 low 档后,只要 9.5 s、$0.0006,成了所有配置里最便宜的。吞吐量 DeepSeek 约 148 tok/s,MiniMax 约 112 tok/s。
长任务:结果反了过来。@rubenssoto_ai 用同一提示词跑同一个长任务,DeepSeek 用了 1 h 28 min、89.5M token、$0.54;MiniMax 用了 1 h 07 min、8.12M token、$0.22,质量没有下结论。@marcthecreatorr 的前端设计任务里,MiniMax 1 h 30 min、约 $0.50,设计更简单;DeepSeek 80 min、$1.15;作者觉得两个都太慢。
同时长对比:@bbfu0382 用 M3.1 Flash Max 对 1017 跑同一测试,两者都用了 38 分钟,作者更喜欢 MiniMax 的成品。他还提到 MiniMax 订阅渠道接近 200 tok/s,$22 套餐只用掉了 5 小时额度的约 6%。
像素风太阳朋克城市动画:@notjazii 用最高推理档测试,MiniMax 40 min、$0(免费期);DeepSeek 50 min、$0.4,作者认为难分胜负。后续帖说 DeepSeek 试了 3 次以上,MiniMax 一次成功。不过 @dustADD 复核后指出“两边都不是一次生成”:MiniMax 先调用了生图工具、重开会话才得到展示的版本,$0 也来自免费期。
审美类任务:多位用户更喜欢 MiniMax
- @ivanainai 生成 Bowser 角色:MiniMax $0 且效果更好;DeepSeek 花了 $0.06,效果更差。
- @davidliyangbing 用“鹈鹕骑自行车”同一提示词测 4 款国产模型,自评满分 4 分:MiniMax 3.63($0.005)、Kimi K3 3.50、DeepSeek V4.1 Flash 3.50($0.026)、GLM-5.3 3.13。帖子没写明 DeepSeek 是否为 1017 版。
- @SandbaseAI(平台方)也做了 4 模型鹈鹕测试,只放了视频,没有量化结论。
这类任务的评判都是主观的,样本也只有一次。Arena WebDev 的大规模盲投结果反而是 DeepSeek 更高。
真实项目与体感:偏向 DeepSeek
- @swarogan 用两者跑了多天真实项目,结论是“DeepSeek 在我测的任务上明显更好”,并认为 MiniMax 的跑分好过实际表现,但没有给出具体数字。
- linux.do 用户 @pigame 在讨论帖里称,MiniMax 在安全场景任务上“比 dsf(DeepSeek Flash)差太多”;同帖 @Sokeu 认为“太空兔”还行,但打不过 GLM-5.3F,更打不过 DS4.1F。
- @xodud_rkd 说,用过 DeepSeek 1017 之后,觉得 M3.1 Flash“有点平庸”。
- @irotaka3 在 OpenCode Go 日常使用中评价 M3.1 Flash“非常快、印象好”,综合性能和舒适度略高于 V4.1 Flash。
只测 MiniMax 的反馈
- 慢、token 多:@TheFaheemAhmad 用同一提示词建 SaaS 页面,M3.1(high 档)调用 17 个 agent、用时 36 min 38 s,Sonnet 5.5 只要 7 min 25 s,快约 5 倍,设计也更好。@alohaproxy 做 3D 机甲组装动画,M3.1 输出 71,038 token、用时 10 min 17 s,对比的 Muse Wonder 只用了 12,488 token、1 min 33 s。
- 长上下文找 key:@MikelEcheve 在约 1M 字符的上下文里 12/12 全部找到,速度快。
- 生成失误:@SahilPanhotra 的孔雀骑自行车 SVG 动画流畅、配色好,但腿像木棍、一只翅膀变成手臂;@mkeremturhan 在 Space Bunny 盲测期的 Roadster kickflip 任务里出现了“雪花轮子”,Haiku 5.5 则正确完成。
- 集成注意事项:思考无法关闭,传 effort:"none" 会返回 400(@wangzailry);简单的 tool-call 回合可能不返回 reasoning_content 字段,agent 循环需要兼容(@csehra42);@MooncastOnline 观察到 M3.1 会分别调用 harness 提供的独立工具,而不是像多数模型那样用一轮 Python 脚本完成。
- 口碑:Reddit 上 Preview 版有用户称“仍然大量幻觉,工具使用不稳定”,也有人称英文写作更自然;linux.do 上的评价多为“实测有点拉,很一般”。
只测 DeepSeek 的反馈
DeepSeek 1017 的实测量明显更多,尤其是本地部署数据:
- 长上下文:@SJRonanMD 在单张 GB300 上做 125K–1M token 的大海捞针测试,每档 6 题,分别找到 4/6、4/6、5/6、4/6,漏掉的都是两跳链;1M 上下文后 decode 仍有 188 tok/s。作者注明每档样本小。
- 本地部署速度:2× DGX Spark 上结构化输出 141.3、代码 100.7、文章 59.2 tok/s(@sudoingX);4× RTX PRO 6000 上 decode 410.9 tok/s(@0xSero,经 @zhouligezhou 翻译);单张 3090 用 2-bit 量化,代码 22.4 tok/s(@vrami_dev)。
- 工具调用:@cha0skvlt 做多步 memory-engine 重构,“没有漏掉一次 tool call”。
- 成本反方意见:据 @Fan_Sa_Xi 汇总的 linux.do 帖子,有用户轻中度使用一天就超过 50 元;@chenxi44779232 说“一下午随便用用 30 块钱就没了”。
- 水平定位:@0xdominus 对比 Opus 5.5 后认为它水平接近 Sonnet,达不到 Opus;@zfv188408 认为必须配合 DeepSeek Harness 才能发挥全部能力。
按维度看结论
| 维度 | 倾向 | 依据与可信度 |
|---|---|---|
| 编程(真实项目、仓库级) | DeepSeek | 官方编程基准全部领先,Arena WebDev 高 77 分,多条体感偏 DeepSeek。中等可信,个人证据大多没有量化 |
| 前端 / 3D / 视觉单次生成 | 偏 MiniMax(审美层面) | 多位用户更喜欢 MiniMax 成品,但都是主观评判、n=1;Arena 盲投反而是 DeepSeek 更高 |
| 办公自动化 / agent 工具调用 | 说法不一 | Automation-Bench 为 MiniMax 自报;个人反馈两边都有正反例,缺少可复现的 agent 对比 |
| 速度 | DeepSeek 吞吐更高 | AA 210.6 对 120.1 tok/s;AIHubMix 148 对 112;番茄钟 109 s 对 211 s。TTFT 受渠道影响很大 |
| 单任务成本 | 取决于 effort 档位和时段 | MiniMax 默认 max 时常更贵,调到 low 最便宜;长任务里 MiniMax 更省;DeepSeek 高峰价翻倍 |
| 长上下文 | 数据不足 | 两边的测试方法不同,不可比 |
| 中文写作 | 数据极少 | DeepSeek 有两条体感称写作进步,MiniMax 只有一条英文写作好评 |
| 幻觉 | DeepSeek 更稳妥 | MiniMax 在 AA-Omniscience 幻觉率 93% |
| 本地部署 | 目前只有 DeepSeek 可行 | DeepSeek 已按 MIT 开源;MiniMax 权重据媒体报道 10-23 才放出 |
怎么选,取决于用法:
- 写真实项目、需要稳定的编程 agent,或者在意幻觉,DeepSeek 1017 的证据更充分。
- 做单页前端、3D、视觉类“一次出图”的任务,可以试试 MiniMax,但建议手动调低 effort 档位,否则默认的 max 档会明显拖慢速度、增加 token。
- 国内工作时间大量调用时,留意 DeepSeek 的高峰价;闲时两者同价。
- 想本地部署,目前只有 DeepSeek 可选。
视频:同提示词的成品对比
社区里有几段同提示词的对比视频,可以直接看成品差异。注意其中 MiniMax 的“$0”成本大多来自免费期。
视频来源:@notjazii,像素风太阳朋克城市动画,M3.1 对 1017
视频来源:@bbfu0382,M3.1 Flash Max 对 1017
视频来源:@ivanainai,Bowser 角色生成并排对比
更多视频(链接):
- @notjazii:像素风太阳朋克城市动画,M3.1 对 1017,最高推理档(10 s)
- @notjazii 后续:DeepSeek 试了 3 次以上后的成品,MiniMax 一次成功(29 s)
- @bbfu0382:M3.1 Flash Max 对 1017,两者都用 38 分钟(30 s)
- @ivanainai:Bowser 角色生成并排对比(14 s)
- @marcthecreatorr:同提示词前端设计任务,MiniMax 约 $0.50、DeepSeek $1.15(59 s)
- @SandbaseAI(平台方):鹈鹕测试,M3.1 / Kimi K3 / DS V4.1 Flash / GLM-5.3(45 s)
- @rubenssoto_ai:同任务长跑,DeepSeek $0.54、MiniMax $0.22
渠道商 EmpirioLabs 还做了 4 个单文件 HTML 动画测试(灯塔、蜂巢、保龄球、抓娃娃机),M3.1、1017、Qwen3.8 Flash、MiMo V2.6 Flash 各一次生成,均为 effort max:MiniMax 四项都最快(254–432 s),DeepSeek 四项都最贵($0.051–0.076,按高峰价 $0.30 / $1.20 计)。这是渠道商自测,没有并入上文统计。
局限与待核实
- 样本量小:个人实测几乎都是 n=1 的单次运行,提示词、harness、渠道、effort 档位、时段都不统一,真正带量化数字的正面对比约 6 条。
- 免费期偏差:MiniMax 在 MiniMax Code(至 10-25)、OpenCode、OpenRouter、Cline 有限时免费,多条“$0”成本来自免费期,不代表实际 API 成本。DeepSeek 在 Qoder 也免费到 10-24。
- 疑似推广或利益相关:部分内容雷同、疑似批量推广的帖子(如“DeepSeek V4.1 Flash UNCENSORED is FREEE”系列)未纳入;渠道商和平台方(AIHubMix、SandbaseAI 等)的数据已标注,权重降低;部分本地部署帖口径高度一致,可能有协同推广;部分营销号以转述为主。
- 官方数据冲突:MiniMax 的 Automation-Bench 有 62.2 和 62.8 两个数字,成本图按 DeepSeek 高峰价计算;DeepSeek 宣传的 Arena 名次与当前页面不一致;DeepSeek 参数量有 552B 和 763B 两种说法。
- 口碑的地域差异:海外 X 上对 MiniMax 的正面声音较多,但不少跑在免费期;中文社区 linux.do 对 MiniMax 普遍不信任,认为是“刷分”。
- 时间窗口很短:MiniMax 正式版发布不到 24 小时,有用户(@yulmu_coffee)称正式版与 Space Bunny 的 checkpoint 不同,早期结论未必适用于正式版。MiniMax 的独立长上下文、中文写作和本地部署数据都还缺,权重放出后会有更多可比数据。