杂文 · 边知道
把厨房也端出来:DeepSeek完全开源DeepInfer
DeepSeek 把正在线上跑 V4.1-Flash 的推理框架 DeepInfer 全面开源,还附上 deepseek-recipe。曾经说“做不到”的事做到了,没给的部分也写在纸上;当推理成本的地板被公开,靠工程黑箱维持的高价就得重新解释。
10 月 20 日下午五点半,DeepSeek 在 X 上发了一条四连帖:内部推理框架 DeepInfer 全面开源,就是正在线上跑 DeepSeek-V4.1-Flash 的那一套。帖子里的说法很朴素——"We're sharing our production stack",目的是帮社区降低算力成本、减少能耗、让 AI 更便宜。顺手还开了一个 deepseek-recipe,把官方 API 背后的 token 编解码逻辑也交了出来。
几个小时,主帖三十多万浏览,五百多条引用。评论区最传神的一条是中文段子:「员工:老大,不能再开源了!再开下去我们连明天要穿什么颜色的裤衩都开完了!」日本网友说得更直接:「1番OpenAIしてておもろい」——最像 OpenAI 的,偏偏不是 OpenAI。
热闹归热闹,这件事真正值得说的,不在“又开源了”,而在 DeepSeek 自己打了自己的脸,而且打得漂亮。
当初说做不到的事
DeepSeek 在 open-infra-index 仓库里留过一篇文章,标题叫《开源 DeepSeek 推理引擎之路》。那时他们认真考虑过把完整内部引擎放出来,最后决定不放,理由列得清清楚楚:代码基于一年多前 vLLM 的早期 fork,改得面目全非;和内部集群管理工具紧紧绑在一起,拿出来没法直接部署;还有一条最实在——“我们是一个小研究团队”,没有精力维护一个大型开源项目。所以退而求其次,拆模块,往现有开源项目里贡献补丁。
这三条理由没有一条是借口,都是工程上的真问题。也正因为是真问题,这次的 DeepInfer 才显得分量重:它不是一个演示用的玩具引擎,README 写明是“powers DeepSeek's large-scale production services”。DeepSeek 没有假装那些困难不存在,而是花时间把它们一件件解开,再把结果交出来。
致谢一栏也写得老实:DeepInfer 最初主要建在 vLLM 之上,还从 SGLang 和 TensorRT-LLM 那里借了思路。从社区拿,再还给社区,账算得清楚。
开源的是哪一块
模型权重开源,大家已经习惯了。可权重只是菜谱,推理框架是厨房。同一份权重,在不同团队手里跑出来的吞吐、延迟、单 token 成本可以差出好几倍。过去大模型公司真正的护城河,往往不在模型本身,而在这套把模型变成便宜服务的工程。
DeepInfer 公开的正是这部分:FlashMLA、DeepGEMM、DeepEP 等自家 kernel,Attention DP 与 MoE EP 的并行方案,DSpark 投机解码加置信度调度验证,SWA bounded replay,batch-invariant inference,deterministic sampling。最后两项尤其有意思——同样输入、同样参数,输出一字不差。对拿模型做 agent、做评测、做复现的人,这比再快几个百分点更要紧。
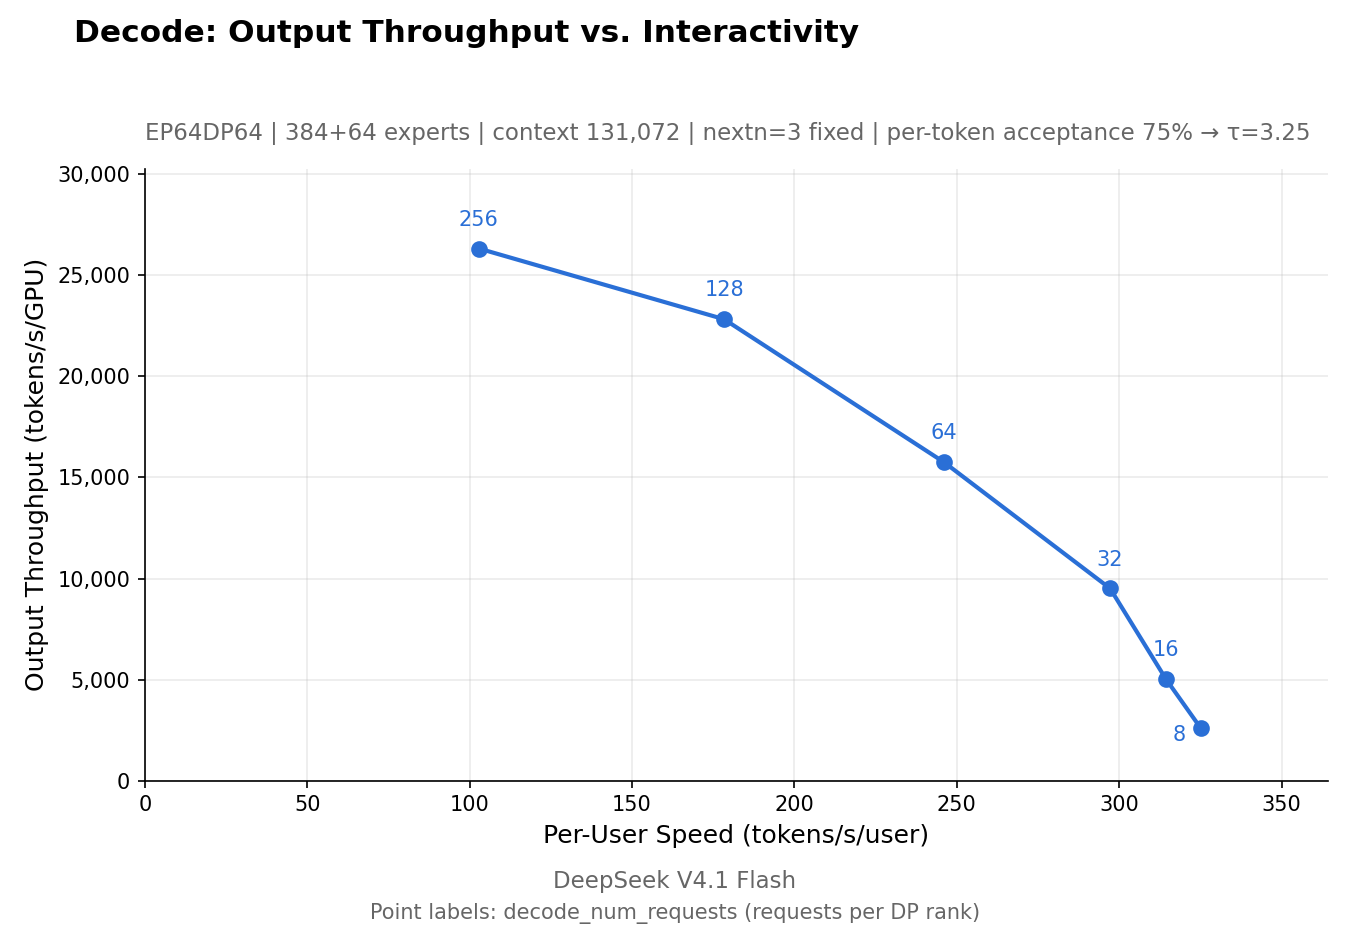
图片来源:DeepInfer GitHub README(DeepSeek V4.1 Flash,decode 基准)
deepseek-recipe 则补上另一个常被忽视的缺口。社区自己部署的 DeepSeek,和官方 API 行为总有细微出入:thinking 模式怎么解析,tool call 怎么切,默认 max_tokens 给多少。recipe 把这些规则摊开——非 thinking 模式默认 8192,thinking 模式 65536,max effort 给到 131072。行为一致,第三方服务商才能真正替代官方,用户才能在不同 provider 之间随意切换。
没给的,也写在纸上
这次开源不是毫无保留。README 列了一份“完整推理服务所需、但本次未包含”的清单:KV cache 系统、Prefill/Decode 分离、数据并行副本之间的负载均衡。硬件只支持 NVIDIA SM100 和华为 Ascend 950 两种。基准测试用的是 4 张卡做 prefill、64 张卡做 decode。
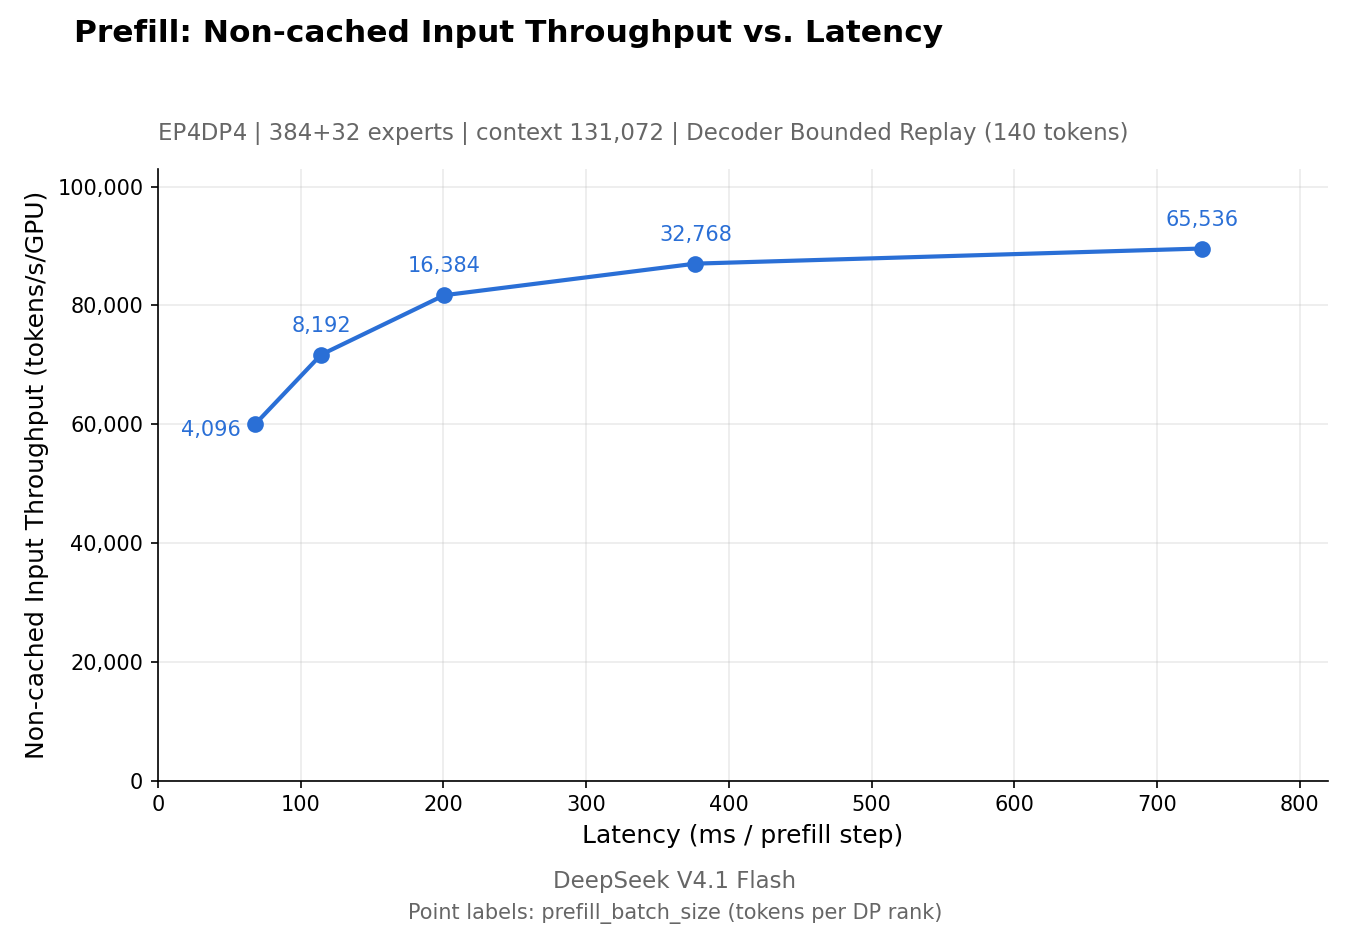
图片来源:DeepInfer GitHub README(DeepSeek V4.1 Flash,prefill 基准)
这意味着两件事。第一,拿一台消费级显卡跑起来的想象可以收一收,这是给云厂商和有集群的团队准备的东西。第二,硬件清单本身就是一份声明——英伟达最新一代与昇腾并列,放在同一张支持表里。韩国网友已经在讨论里读出了这层意思。工程文档不喊口号,但选择支持谁,本身就是立场。
把缺了什么写清楚,比含糊地说“全面开源”诚实得多。真正的开源从来不是一键部署的魔法,而是让别人少走几年弯路。
便宜是最锋利的武器
有人在引用里算得很直白:“Cheaper here means more tokens out of the same hardware.” 同样的硬件吐出更多 token,就是更低的价格。当推理成本的地板被公开写进 Apache 2.0 协议,任何一家还在靠工程黑箱维持高价的服务商,都得重新解释自己的报价单。
这才是 DeepSeek 这一手的锋利之处。它没有在发布会上宣布降价,也没有发长文谈愿景,只是把厨房的门打开,让所有人看见一道菜的成本到底是多少。行业里很多“贵”,原本就靠“看不见”撑着。
四连帖的最后一条写着:Open models. Open kernels. Open inference. 三个 open 叠在一起,像一句口号。但比口号更有说服力的,是那篇曾经说“我们做不到”的旧文章还挂在仓库里,没有删。说过做不到,后来做到了,再把旧话留在原处——这份坦荡,比任何一条 benchmark 曲线都更难复制。
参考来源
- DeepSeek,Introducing DeepInfer(X 四连帖)(2026-10-20)
- GitHub,deepseek-ai/DeepInfer
- GitHub,deepseek-ai/deepseek-recipe
- DeepSeek,The Path to Open-Sourcing the DeepSeek Inference Engine
- 第一财经,相关报道(2026-10-20)