边课堂 · 边知道
UC伯克利 EE290/194:把大模型当全栈工程来上
伯克利 Scalable AI:H100 上走完架构→预训练→后训练→推理全栈
大模型在现代规模上,受硬件、互联和 serving 经济约束的程度,并不亚于受算法本身的约束。矩阵乘法、内存带宽、数值精度、优化器稳定性,共同划定了可行的设计空间。
总览
UC Berkeley 秋季学期(Fall 2026)开设 EE 290 / 194 Scalable AI: Bridging Theory, Understanding, and Practice,由 Anant Sahai(EECS)与 Jiantao Jiao(EECS & Statistics)主讲,GSI 为 Nathan Henry、Hanchen Li、Mayank Mishra,NVIDIA 侧基础设施由 Venkat Srinivasan 支持,算力赞助方是 NVIDIA。上课时间是周一、周三 12:30–1:59 PM,地点 Gateway Building B1022。
课程的核心问题写得很直白:如何把大规模 AI 当作全栈工程产物来 build、train、deploy——硬件约束、软件栈与优化动力学共同决定模型行为与性能。模型被当成一张要在硬件、数据与 serving 经济硬约束下,被训练、特化、评测、部署、监控并持续迭代的计算图。工具栈贴近工业实践:NeMo AutoModel、Curator、Data Designer、NeMo RL/Gym、Minitron、Dynamo、TensorRT-LLM、SGLang、vLLM,以及部署侧的 NeMo Guardrails 与 Garak。大纲也点出:了解世界如何在 NVIDIA 上搭起 AI 基础设施,以及还能把它做得更好。
春季学期(Spring 2026)已有一届;秋季主页仍挂着往届链接,学生 blog 里能看到此前在单节点 8×H100 上做 MFU 优化与从零预训练的公开复盘。
课程结构
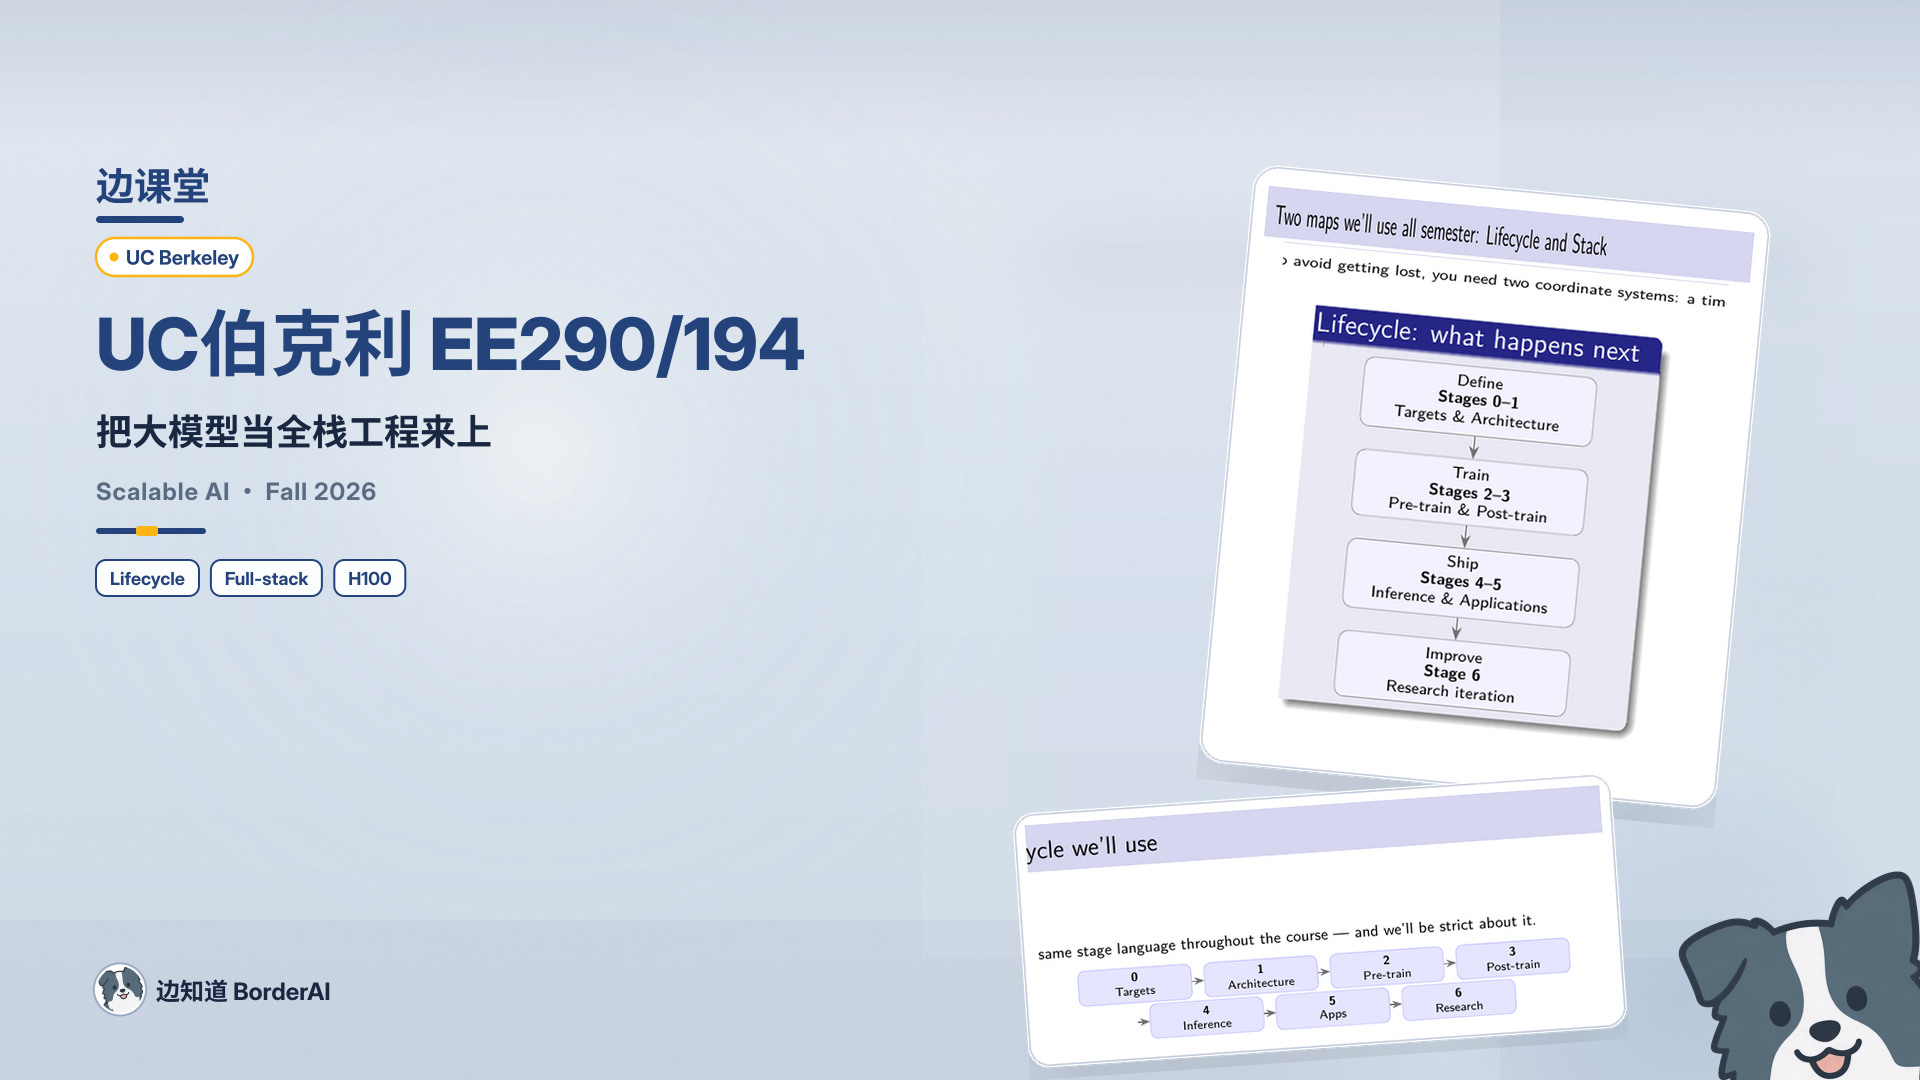
整门课按生命周期推进:Architecture → Pre-training → Post-training → Efficient inference → Applications → Research greenfields。讲次计划可能调整,当前大纲大致如下。
Part 1 Architecture:L1 总览与现代 AI stack;L2–3 performance(Roofline、matmul、token economics);L4 MoE / sparse / long-context;L5–6 parallelism、FlashAttention、Sonic MoE;L7 NeMo AutoModel。架构选择(dense vs sparse、MoE、长上下文、并行策略)与优化器选择(包括新兴的 Muon、SOAP)会直接作用于收敛、效率与可部署性。
Part 2 Pre-training:tokenization 与 causal LM;用 NeMo Curator 做数据;优化器;Nano-V3 预训练案例。
Part 3 Post-training:SFT / RL 生命周期;Data Designer;NeMo RL/Gym;Nemotron-NanoV3 后训练案例。
Part 4 Inference:Dynamo、TensorRT-LLM、vLLM、SGLang。
Part 5 Applications:context engineering、harness design、safety / guardrails。
Part 6 Research greenfields:研究方向讨论,加上项目报告与 poster。
多数 lecture PDF 已挂在主页的 assets/lecture_slides/ 下,可按讲次对照阅读。
作业与项目
没有考试。成绩构成是:Research project 50%、Assignments 35%、Explainer video 10%、Attendance & participation 5%。任一组成部分不合格,整门课不及格。只能拿 letter grade,且必须按最大学分修读。
四个小组作业,均有口头 checkoff:
- A1 Performance Engineering
- A2 Pre-Training
- A3 Post-Training
- A4 Inference and Serving
全年共 3 个 slack day,单个作业最多用 1 天。总成绩中有 10% 来自 enhancement(计入 Assignments 的 35%):每组只需增强一个作业(加题或把程序部分做得更具挑战)。
研究项目开放选题,看重 impact(例如开源 PR、公开报告、arXiv)。过程里有 peer review,每人还要交一段白板 explainer video:就课上某个主题讲得比课堂更深,留给同学用。项目节奏从假设陈述、proposal,到 midterm check-in、draft、presentation、poster 与最终交付,主页与 syllabus 都列了里程碑日期。
算力
班级分成 8 组、每组 4 人;每组学期内固定一台 H100 节点(8×H100),共 8 个节点,跑在 GCP 上,并分配静态公网 IP 供 SSH。需要多机时,要和其他组约好有限时间窗口共用节点。机房与配额问题统一走 Ed。
适合谁
这是一门持续投入的小组课:每周有算力使用、组队推进和当面 checkoff。Syllabus 写得很明确——如果预计学期里会有大量重复性冲突(例如密集面试),不建议选。Q&A 只走 Ed,不用 Slack。第 1–2 周有 onboarding questionnaire,座位与算力分配在第二周末前敲定;问卷看的是具体证据(上过什么课、做过什么项目),不是形容词。
背景上,AI/ML 与 systems 两边都要能接得上:概率与优化、深度学习与评测,以及 OS / 体系结构 / 分布式与 GPU performance 一侧的工程能力。课程容量有限,cohort 会刻意在 model 与 systems 技能之间做平衡,方便端到端项目落地。
怎么跟
校内以课程主页为 source of truth:大纲、幻灯片、作业与截止日都会更新。校外读者同样可以直接跟公开材料——Fall 2026 讲义陆续放出,Spring 2026 页面与学生 blog 也能对照看一届完整生命周期是怎么走完的。关心大模型从架构、预训练、后训练到推理 serving 的全栈工程,可以把这页收进书签:https://scalable-ai.eecs.berkeley.edu/F2026/