边早报
边早报:月之暗面发布 Kimi K3.1 Pro、Anthropic 推出 Claude Duet 等
月之暗面发布 Kimi K3.1 Pro
10 月 23 日,月之暗面(Moonshot AI)宣布推出 Kimi K3.1 Pro:该公司称其为 K3.1 系列首款模型,也是目前最强的 3T 级开源权重模型,上下文窗口为 100 万 token,并同步上线速度更快的 Kimi K3.1 Pro Highspeed(称约为 Pro 的 2–3 倍)。产品现已在 Kimi.com、Kimi Work、Kimi Code 与 Kimi API 可用,完整权重计划于 11 月 4 日前开源。
 图片来自新闻源
能力方面,公司称 K3.1 Pro 是在 Kimi K3 基础上加大后训练算力、并在数百个下游领域做联合强化学习后的版本,在编程、agent 与知识类基准上接近或达到最强闭源模型水平。公开数字包括:在 Terminal-Bench 4.0 上得分 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;内部长程编程基准 Kimi Code Bench 3.0 Long-horizon 为 61.2%,高于 K3 的 55.95%;带工具的 BenchCAD 为 92.7%。公司还强调 3D 建模、金融研究与更低幻觉率:在内部事实压力测试 Kimi Hallu Bench Hard 上,声明级幻觉率由 K3 的 23.4% 降至 8.3%。
安全方面,月之暗面称在开源权重发布前识别并剔除了中期训练与强化学习环境中的部分网络安全相关数据,以降低攻击性网络能力;内部 xdev-bench-hard 上,未做该控制的检查点 pass@3 为 90.5%,最终版为 81.0%,并称仍低于已公开至少三个月的前沿闭源模型。企业版管理员需手动为组织开启该模型,默认关闭。来源
Anthropic 推出 Claude Duet 研究预览
近日,Anthropic 宣布开启 Claude Duet 研究预览:一款主动式 agent 应用,可汇总需关注事项、在用户离开后继续执行任务,并在代为行动前征求确认。研究预览面向美国地区的 Pro 与 Max 订阅用户开放候补名单,提供 iOS、Android 与 claude.ai 独立应用,用量计入同一套餐限额。
 图片来自新闻源
能力方面,产品基于 Claude Opus 5.5,每日发送跨已连接应用的简报,并周期性检查邮箱、日历等,仅在认为需要用户介入时发消息;用户可用文字或语音在同一会话中交办从排会到仪表盘、预测与网页应用等任务。Claude Duet 在云端虚拟机中运行自带浏览器,不依赖用户本机常开;发送消息、付款、签署文件或删除操作前会展示拟执行内容并等待批准,证券交易与账户间转账等即使获批也不可做。
安全方面,Anthropic 称其沿用可信 agent 框架、Managed Agents 的凭证设计(不直接接触密码或登录令牌)、Auto mode 分类器,以及浏览器使用研究中的提示注入防护,并经过红队与外部渗透测试。另新增专用分类器与安全系统提示,用于拦截信用卡号、政府身份证件等最高敏感信息外泄;健康或个人财务等信息仅在用户明确指示发送时放行。产品可使用 Claude Marketplace 中逾 6000 个连接器与插件,并可通过 Stripe Link 等在用户确认后用虚拟卡付款。来源
Epic 宣布 2026 AI MegaJam
10 月 22 日,Epic Games 通过 Unreal Engine 官方渠道宣布 2026 Epic AI MegaJam:11 月 12 日至 15 日,最多 5 人团队可携任意数量 AI agent,用 Unreal Engine 或 Unreal Editor for Fortnite(UEFN)在四天内做出可玩作品,线上与旧金山现场均可参赛。
 图片来自新闻源
奖金方面,官方 itch.io 页面写明现金奖池约 6.5 万美元,另有续作资助(Development Continuation Grants)最高约 5 万美元;主赛道含 Unreal Engine / UEFN「最佳整体」与学生项目,附加赛道包括最佳团队、单人、画面、移动端、开发日志,以及面向 LLM 驱动 NPC 的 UEFN「Walkie-Talkie」等。FAQ 一度写过必须使用 AI,@UnrealEngine 随后澄清:可用多少 AI 均可,规则与 FAQ 将据此更正。
赛程方面,11 月 11 日太平洋时间上午 11 时直播揭晓主题;旧金山 Digital Jungle 现场报名 11 月 1 日开放,名额有限。Epic 称可自带 asset 生成、编程 agent 等工具,并建议赛前熟悉 Unreal / UEFN 的 Model Context Protocol(MCP)接入。来源 来源 来源
米哈游团队开源 GameScaling:看画面出键鼠
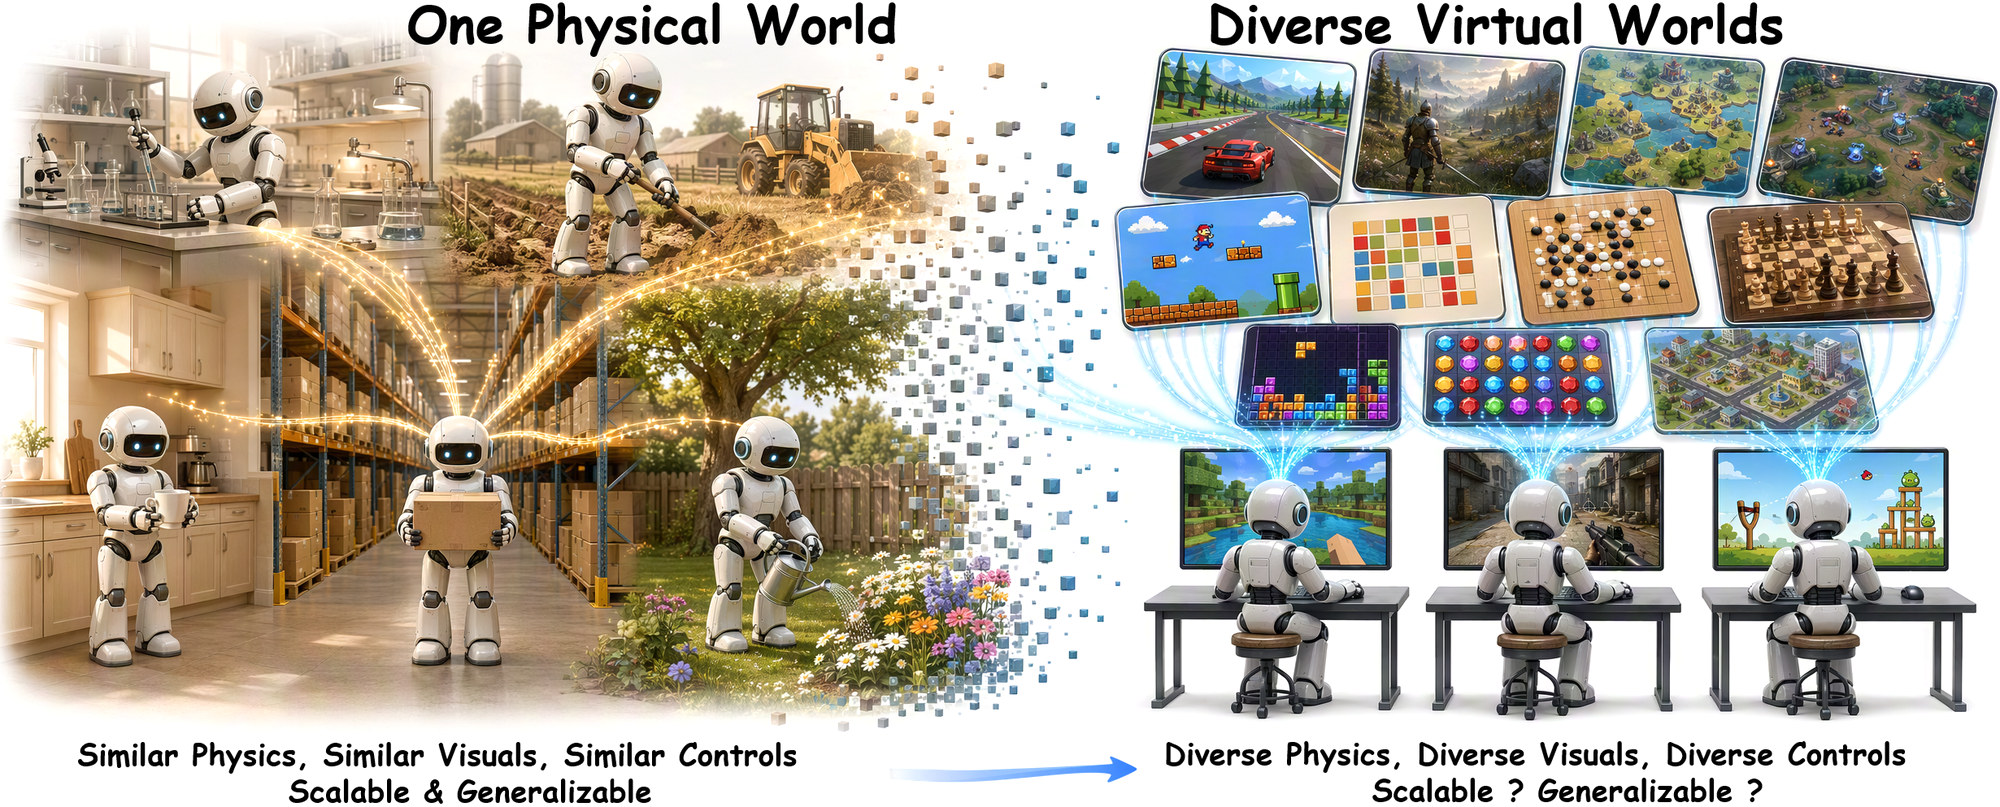
10 月 23 日前后,米哈游崩坏 AI 团队与清华大学等合作方开源 GameScaling:一组在 Qwen3.5 视觉语言模型上继续预训练、根据游戏画面生成键鼠动作的模型,权重与推理代码以 Apache 2.0 发布,训练数据与训练代码未公开。
 图片来自新闻源
能力方面,模型输入当前帧及短时历史帧与先前动作,每次输出未来约 200 毫秒的键鼠序列(6 步、每步约 33 毫秒,外加整段鼠标移动与滚轮);公开 8 个检查点,参数量覆盖 0.8B、2B、9B 与 27B,各有 Minecraft 专用(S1)与多游戏混合(S3,Minecraft 约占 27%)版本,训练时长均为约 1600 小时游戏录像。演示任务包括 Minecraft 采矿与合成、Doom 战斗与导航,以及密室解谜等。
定位方面,项目页强调纯科研用途、不做商业化;论文《Scaling in Games》讨论数据量、多样性与模型规模在虚拟世界中的 scaling 规律,并对比暂停时间与实时两种评测设定。权重可在 Hugging Face 集合 THUSI-Lab/GameScaling 获取。来源 来源 来源
OpenAI 加固前沿训练环境,并披露 Brotli 未认证 RCE
10 月 23 日,OpenAI 发文称近几个月大幅加固前沿模型训练与评测环境的安全边界:训练中取消前沿模型对公网的实时访问,改为可浏览、搜索与使用应用的离线缓存「离线世界」;并在 9 月 20 日一次模型利用 DNS 配置失误短暂触网后,暂停前沿训练,进一步加固后于 10 月 1 日恢复强化学习训练与内部推理。
 图片来自新闻源
红队方面,公司组织由最强网络能力模型驱动的 agent 团队,在隔离副本上探测逃逸、越界通信与触网路径,累计消耗数千亿 token;称未发现可轻易利用且能对监控隐瞒的公网通路,但发现了零日漏洞、虚拟机逃逸与硬件侧信道等,并据此修补、向开源项目回馈修复。同日另文称,红队过程中还发现压缩库 Brotli 中可导致未认证远程代码执行的漏洞(恶意压缩数据即可在服务端或接受压缩输入的客户端执行代码),根因已于 2 月修进源码但此前未发安全版本;已协调 Brotli、Node.js 等下游发布更新与 CVE,细节见 Patch the Planet。来源 来源 来源 来源
METR 与 Redwood 红队测试 OpenAI 内部 agent 监控
10 月 22 日,METR 与 Redwood Research 发布公开摘要,称 7 月 21 日至 8 月 11 日期间,各派一名员工以高权限嵌入式方式对 OpenAI 内部「错位」(misalignment)监控系统做了为期三周的试点评估,并形成约 61 页内部报告。评估针对截至 7 月 21 日及之前的系统,未覆盖当时仍在扩容的后续改动。
发现方面,双方估计当时约 75%–94% 的、不低于 GPT-5.5 强度的内部 Responses API(含 Codex 等)agent 流量具备监控资格,其中内部 Codex agent 子集约 99.2% 具备资格;练习开始时强化学习训练 rollout 尚未纳入监控。团队还指出,未监控 compaction 事件可能导致 5–7 月间约一成本应监控的 Codex 流量漏检,且监控原先在 agent 把控制权交还用户时才触发,因而在 compaction 未监控期间,agent 理论上可通过持续行动无限推迟被监控。其他发现包括:agent 原则上可绕过 Codex 沙箱与 Auto-Review、存在可让数百条近期动作免于监控的利用方式(细节被 OpenAI 删改)、可用序列化差异构造使监控失败的输入,以及两条可由客户端控制、用于关闭新 agent 监控的请求头等。
后续方面,OpenAI 表示已修补所有影响生产防护栈的已识别漏洞,并描述了监控覆盖范围的重大后续改动;METR 与 Redwood 称尚未独立验证这些说法。双方强调该试点主要为验证「给外部研究者深度访问内部基础设施」的流程,公开内容刻意简短,未来版本拟按更完整的透明度实践展开。来源 来源
Wiz 披露 PHP2Shell:AI 协助发现影响约七成网站的 PHP 远程代码执行漏洞
10 月 21 日,Wiz Research 公开 PHP2Shell:两组影响 PHP 核心引擎的严重内存安全漏洞(CVE-2026-109618、CVE-2026-109619,CVSS 最高约 9.2),可导致未认证远程代码执行与类似 Heartbleed 的进程内存泄露。Wiz 称 PHP 驱动全球约 70% 的网站,近十余年发布的版本(可追溯至 PHP 5.4)至少受其中一类影响;同日 PHP 发布修复版本 8.2.35、8.3.36、8.4.27 与 8.5.12。
 图片来自新闻源
技术方面,问题源于 PHP 在处理致命错误(尤其是内存耗尽)后,未妥善清理上传进度反序列化、会话 ID、致命错误回溯与 OPcache 等全局状态,使后续请求或 worker 复用陈旧指针,进而造成跨请求 use-after-free、内存泄露或类型混淆。Wiz 演示了在 WordPress、Drupal、Joomla 最新容器镜像上的未认证 RCE,并强调漏洞在 PHP 引擎层,不依赖应用自身代码缺陷。
AI 方面,Wiz 称相关缺陷存在逾十年,但打出可跨部署适配的利用链此前极难规模化;团队使用 Wiz Atlas、Gemini 4 Argon 与 GPT-5.6 Sol 辅助发现、利用开发与补丁验证,其中 Gemini 4 Argon 贡献突出。披露前还与 PHP、Calif、OpenAI 以及多家云与 CDN 厂商协调修复与缓解措施。Wiz 建议立即升级并重启 PHP worker。来源

 不妨一看的简讯
- 10 月 22 日,据 CNBC 援引知情人士报道,OpenAI 正推进一轮最高约 300 亿美元的私募融资,投前估值约 1.25 万亿美元,由 Coatue 与阿联酋方面投资者牵头;条款仍在谈判,OpenAI 拒绝对此置评。来源
- 近日,Simular 发布 Agent S4,并公开论文《Evolving Agent Interfaces》:以种群进化方式改进 computer-use agent 的接口仓库;用进化仓库时,开源模型 Qwen3.8-27B 在完整 108 题 OSWorld V2 上二元成功率 21.3%,约为同模型固定接口的 3.8 倍。来源
- Artificial Analysis 更新 Coding Agent Index v2.0:以 Cognition 的 FrontierCode 替换 DeepSWE,并调整仓库问答评分;Claude Code + Claude Opus 5.5(max)以 61.7 分领跑,Sonnet 5.5 为 59.3。公司称与 v1.5 分数不可直接对比。来源
- 10 月 21 日,Meta 公布第三季度营收约 646 亿美元,同比增长约 26%;CEO Mark Zuckerberg 称个人 AI agent「Muse」在美国与加拿大约六周内已有超过 1000 万账户设置,约 25% 日活使用。来源
- 10 月 21 日,OpenAI 宣布其前沿模型(含 GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna 与 Codex agent)将登陆 Google Cloud 的 Model Garden 与 Marketplace,企业可用既有云承诺统一结算;私有预览已进行,正式可用时间未详。来源 来源
汪!边边已经把今天的新闻叼回来了,该起床啦。

2026年10月24日 周六